Qwen3-4B DSpark
1 Design
1.1 Baseline Design
DSpark baseline 读取 Qwen3-4B 的中间层隐藏状态,用五层 GQA backbone 并行预测接下来 7 个位置的基础 logits,再由 Markov head 根据前一个 token 逐步修正。Target、token embedding 和 LM head 均冻结。并行预测与顺序采样的推导见 Speculative Decoding §5.2 DSpark。
下表列出 baseline 的模型配置。
| 项目 |
设置 |
| 最大序列长度 |
4096 tokens(完整对话,含 prompt 与 response) |
| Draft 架构 |
5 层;隐藏维度 2560;FFN 中间维度 9728;GQA:32 个 Q heads、8 个 KV heads,head dim 128 |
| Aux 层 |
[1, 9, 17, 25, 33] |
| Block size |
7;Backbone 输入为 [anchor, MASK × 6] |
| 监督 |
仅监督 response |
| Markov head |
Vanilla,rank 256 |
| 总参数量 |
GQA baseline:约 1.393B(含冻结的 embedding 与 LM head) |
| 可训练参数量 |
GQA baseline:约 615.2M |
DSpark baseline 的模型配置
1.2 Ablation Study
以下训练消融均以 GQA baseline 为对照,各改一项;SWA 以 MLA 为对照。
\(\blacksquare\)Tau loss. 附加
\[
L_{\tau}=\frac{8-\tau}{7},
\]
系数 0.1。CE 与 L1 仍按位置衰减,该项不衰减。
\(\blacksquare\)MLA. 将 backbone attention 替换为 MLA。32 个 query heads,每头 QK 为 64 content + 64 RoPE,V 为 128,KV latent 为 512。
\(\blacksquare\)SWA. 在 MLA 上将历史窗口限制为 \(W\in\{1024,512,128\}\)。对位置为 \(a\) 的 anchor,历史范围固定为 \([\max(0,a-W+1),a)\),块内仍双向可见。
\(\blacksquare\)Context-only. 移除当前 draft block 的 K/V,只读取早于 anchor 的 target context,保留 anchor 输入。
\(\blacksquare\)All-mask. 将 backbone 输入改为 [MASK × 7],保留块内双向 attention。Markov head 仍从 anchor token 开始生成。
\(\blacksquare\)三层 aux. 将 target 特征层改为 [1, 17, 33]。
1.3 Markov MLA
该变体将 backbone attention 替换为 MLA,并在原有 Markov head 的 W₁ → W₂ 之间加入 MLA。Backbone 并行计算各位置的基础 logits,Markov head 则根据上一个生成 token 和 target context,逐步修正 logits 并采样。
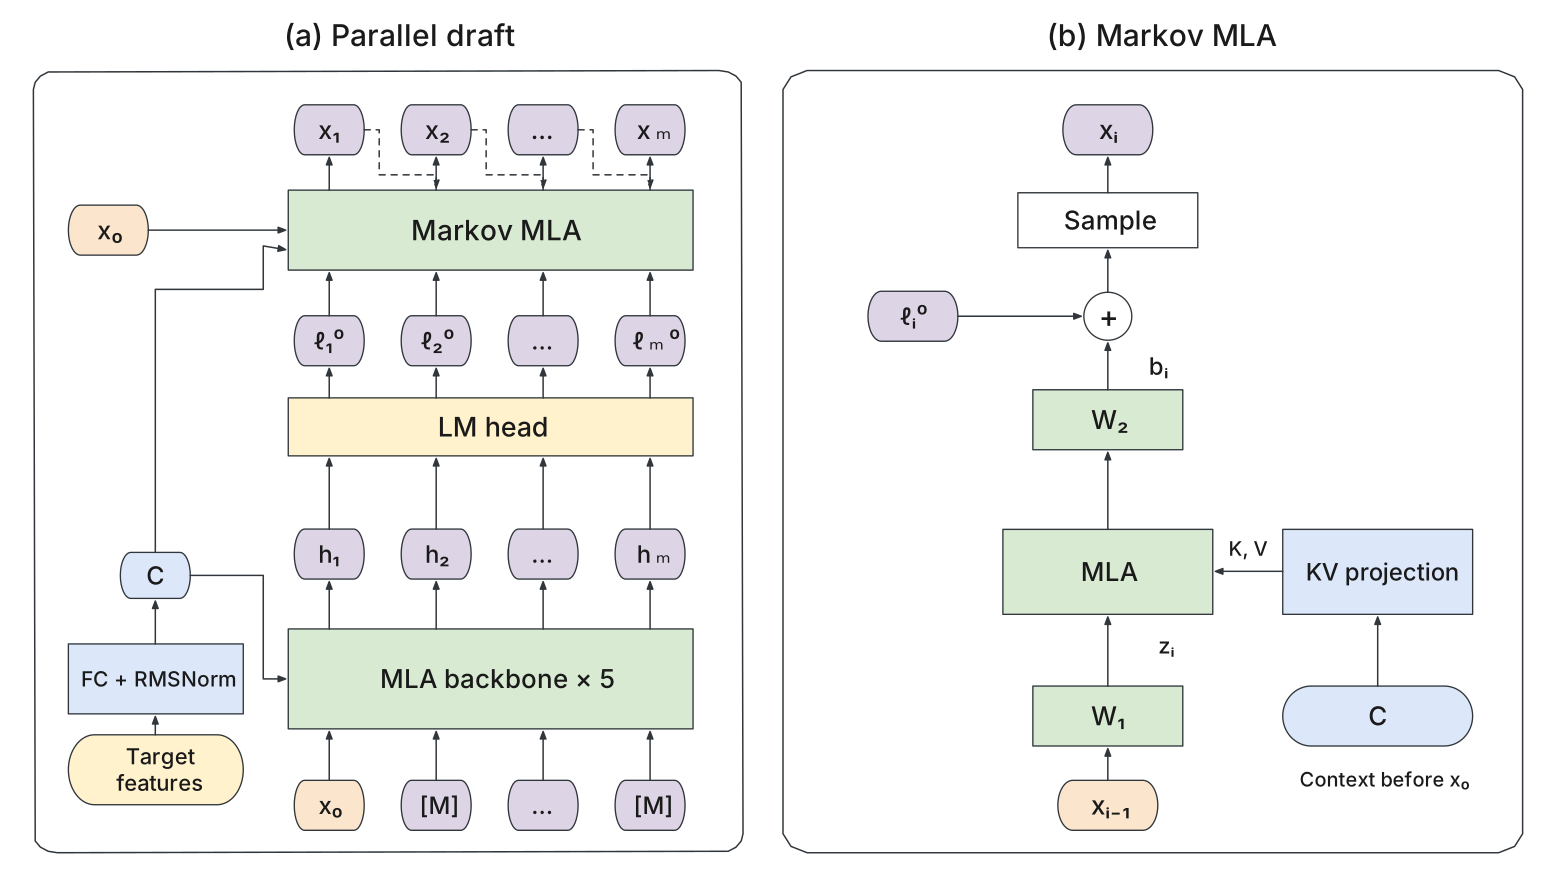
Fig. 1: Backbone MLA 与 Markov MLA 架构
五层 target features 按 token 拼接,经 FC 和 RMSNorm 融合为 \(C\)。Markov MLA 的 Q 来自上一个 token 的 embedding \(z_i=W_1[x_{i-1}]\),K/V 由 \(C\) 投影得到。以本轮起始 token \(x_0\) 为边界,所有生成步骤都读取同一段早于 \(x_0\) 的 context:
\[
b_i=W_2\,\mathrm{MLA}(z_i,C),\qquad
\ell_i=\ell_i^0+b_i.
\]
其中 \(\ell_i^0\) 为 backbone 的基础 logits,\(b_i\) 为 Markov 修正项。Markov MLA 不加残差,其投影权重与 backbone 独立。
1.4 Markov-Engram
Markov-Engram 沿用五层 GQA backbone,在 Markov head 的 W₁ → W₂ 之间加入 n-gram 查表。预测 \(x_i\) 时,分别用以 \(x_{i-1}\) 结尾的 2-gram 和 3-gram 查表。每阶用 8 个哈希头,每头读出 16 维,16 个结果拼成 256 维记忆向量 \(m_i\)。第一步预测 \(x_1\) 时,3-gram 由 anchor \(x_0\) 和它之前的两个 token 组成。
负责预测 \(x_i\) 的 backbone hidden 投影为 256 维 query \(q_i\),\(m_i\) 投影为同宽的 key \(k_i\)。两者分别经过 RMSNorm,再用缩放点积得到标量门控,决定当前上下文采用多少查表结果:
\[
g_i=\sigma\!\left(\frac{q_i^\top k_i}{\sqrt{256}}\right),\qquad
\ell_i=\ell_i^0+W_2\!\left(W_1[x_{i-1}]+g_i W_V m_i\right).
\]
\(W_V\) 以零初始化,使训练起点的 logits 与同 seed 的 baseline 一致。下表按单个预测位置列出计算维度,7 个位置共享全部参数。
| 环节 |
维度或计算 |
新增可训练参数 |
| \(W_1\) 查表 |
上一个 token ID → 256 维 |
0(沿用) |
| 2-gram 查表 |
8 头 × 16 维,每头约 131K 桶(合计 1,048,988 桶) |
16,783,808 |
| 3-gram 查表 |
8 头 × 16 维,每头约 262K 桶(合计 2,097,418 桶) |
33,558,688 |
| 拼接记忆 \(m_i\) |
128 + 128 → 256 维 |
0 |
| Query 投影 |
backbone hidden:2560 → 256 |
655,360 |
| Key 投影 |
\(m_i\):256 → 256 |
65,536 |
| 门控 \(g_i\) |
Q、K 各做 256 维 RMSNorm,缩放点积后经 sigmoid 得到标量 |
512 |
| Value 投影 \(W_V\) |
\(m_i\):256 → 256 |
65,536 |
| 残差与 \(W_2\) |
两个 256 维向量相加,再投影至 151,936 维词表 |
0(沿用) |
| 合计 |
新增 BF16 权重约 97.52 MiB |
51,129,440 |
Markov-Engram 各环节的维度与相对 baseline 的新增参数量
2 Training Metrics
| 实验 |
CE ↓ |
L1 ↓ |
Acc. ↑ |
τ ↑ |
Δτ |
| GQA baseline |
1.1191 |
0.4550 |
74.35% |
4.9591 |
0.00% |
| GQA + tau loss |
1.1260 |
0.4546 |
74.34% |
4.9860 |
+0.54% |
| MLA |
1.1402 |
0.4623 |
74.00% |
4.9368 |
-0.45% |
| MLA + SWA1024 |
1.1571 |
0.4690 |
73.65% |
4.9008 |
-1.17% |
| MLA + SWA512 |
1.1853 |
0.4787 |
73.16% |
4.8523 |
-2.15% |
| MLA + SWA128 |
1.2830 |
0.5140 |
71.35% |
4.6668 |
-5.89% |
| GQA context-only |
1.1795 |
0.4767 |
73.30% |
4.8718 |
-1.76% |
| GQA all-mask |
1.1860 |
0.4780 |
73.51% |
4.8791 |
-1.61% |
| GQA 三层 aux |
1.1676 |
0.4735 |
73.36% |
4.8837 |
-1.52% |
各训练消融的指标与相对 baseline 的 τ 变化
3 训练消融分析
3.1 Tau loss
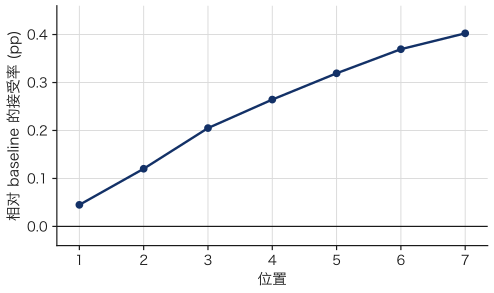
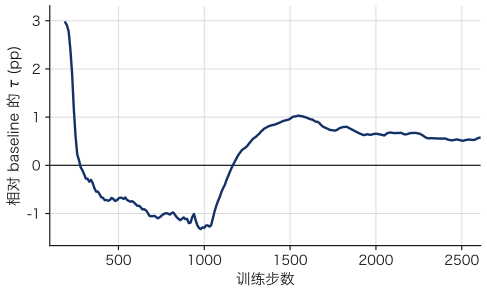
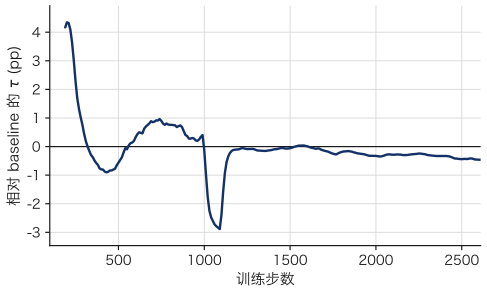
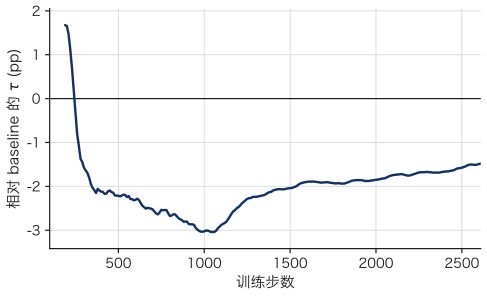
Tau loss 使 \(\tau\) 提高 0.54%,收益主要出现在后续位置和训练中后期。
3.2 MLA 与历史窗口
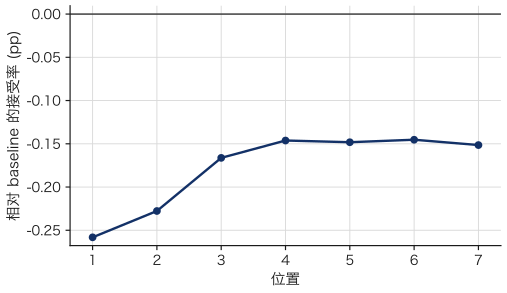
MLA 的可训练参数从 615.2M 降至 612.1M,\(\tau\) 下降 0.45%,差距未随 draft 位置明显扩大。
MLA 的压缩表示每层每 token 包含 \(512+64=576\) 个数,约为 GQA 的 \(1/3.6\)。当前实现缓存展开后的 K/V,这一比例不代表实际 KV cache 的节省。
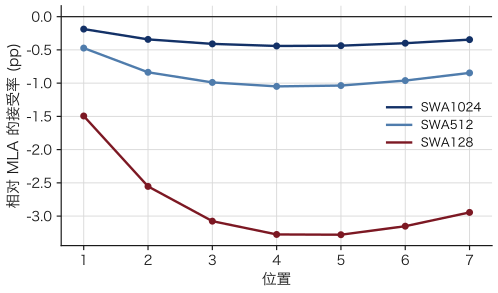
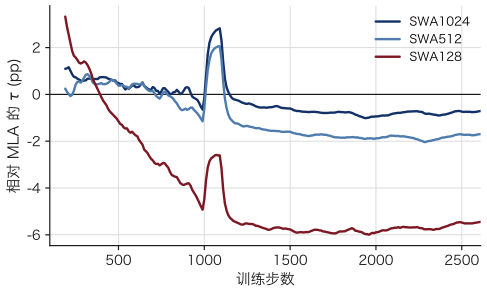
进一步缩短历史窗口会降低接受长度,窗口越小损失越大。SWA128 相对 MLA 的 \(\tau\) 下降 5.47%,且差距在训练早期已出现。块内双向 attention 无法完全补偿历史信息的减少。
3.3 Anchor 输入与块内 K/V
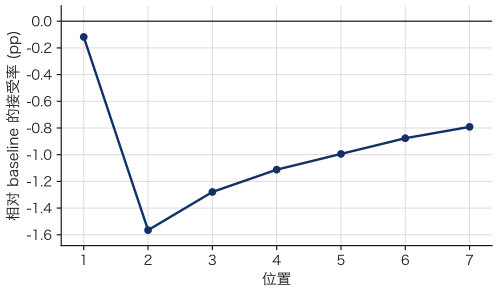
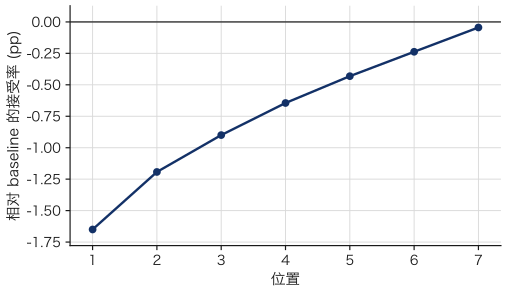
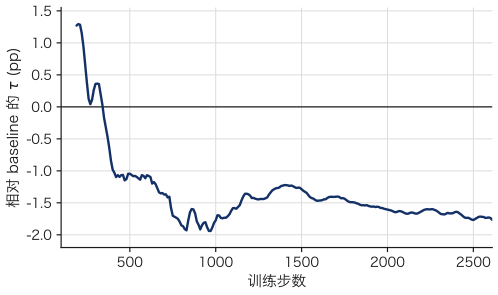
Context-only 和 all-mask 的 \(\tau\) 分别下降 1.76% 和 1.61%,但影响的位置不同:移除块内 K/V 主要影响后续位置,移除 anchor 输入主要影响首位置。两组均保留 Markov head 的前驱 token 输入。
3.4 三层 aux
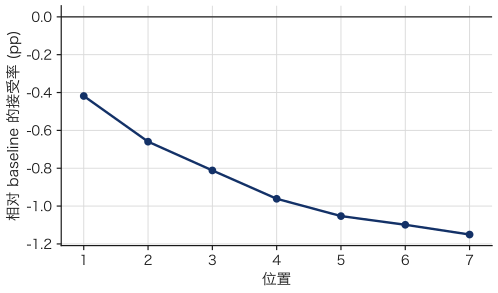
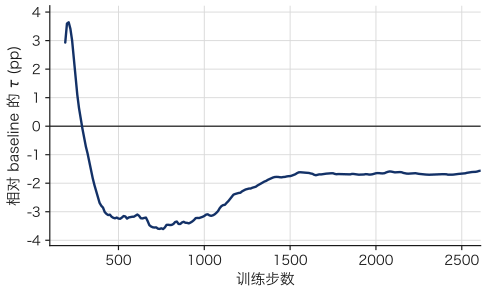
减少特征层使输入投影参数从 32.77M 降至 19.66M,总可训练参数减少 2.13%,代价是 \(\tau\) 下降 1.52%,后续位置受影响更大。
训练过程曲线
4 Evaluation
4.1 Settings
生成评测使用 Qwen3-4B 的 non-thinking 模式,draft 每轮提出 7 个候选 token。
训练数据集
训练消融使用 Open PerfectBlend。我们用 Qwen3-4B 在 non-thinking 模式下重新生成回复,采样参数为 temperature=0.7、top-p=0.8、top-k=20、min-p=0,每条回复最多生成 4,096 个 token。重新生成后共有 1,339,875 个训练样本。
训练方式
Offline 和 online 训练均使用预先生成的对话样本,由冻结的 Qwen3-4B 提供 target hidden states。每个样本最多采样 512 个 anchor,仅监督回复部分。Baseline 的损失为 \(0.1L_{\mathrm{CE}}+0.9L_{\mathrm{L1}}+L_{\mathrm{conf}}\),位置权重为 \(\exp(-i/4)\),其中 \(i=0,\ldots,6\)。
-
Offline training 用于第 2 节的训练消融。训练前先计算全部样本的 target hidden states,写入约 38 TB 的磁盘缓存,后续各轮训练复用这份缓存。Draft 使用 4 张 GPU,每卡 micro-batch 为 1,梯度累积 128 次,global batch size 为 \(4\times1\times128=512\)。峰值学习率为 \(6\times10^{-4}\),warmup 占完整 26,160 步学习率计划的 4%。消融实验实际训练 2,616 个 optimizer step,约 1 个 epoch。
-
Online training 由 SGLang 在训练期间计算 target hidden states,SpecForge 从缓冲区读取并训练 draft。Target 计算下一批数据时,draft 可以并行训练当前批。MAL vs. Epochs 的 baseline 使用 7 张 GPU 训练 draft,每卡 micro-batch 为 4,梯度累积 18 次,global batch size 为 \(7\times4\times18=504\)。Markov MLA 和 Markov GQA 的对比实验也采用 online training。
测试数据集
- GSM8K 收录小学数学应用题,通常需要多步算术运算才能得到答案。两种设置都使用全部 1,319 道测试题。本文脚本用
Question: … 给出当前题目,在下一行用 Answer: 引出回答。0-shot 直接使用这一提示。5-shot 在每道测试题前附上相同的五组示例,取自训练集前五道题及其完整解答。数据集
- HumanEval 包含 164 道 Python 函数补全题,每题给出函数签名和文档字符串,要求模型补全函数实现。数据集
- MT-Bench 包含 80 组双轮对话。每组先给出一个问题,第二轮保留首轮问答作为上下文,再提出追问。论文
- MATH-500 收录从 MATH 测试集选出的 500 道竞赛数学题,涵盖代数、几何、数论等七个主题。本文使用全部 500 道题评测数学推理过程中的 draft token 接受率。数据集
- AIME 2024 收录 2024 年美国数学邀请赛(AIME I 和 AIME II)的全部 30 道题,每题的答案都是 0 至 999 的整数。本文对 AIME 和 MATH-500 使用相同的提示,要求模型逐步推理,并将最终答案写在
\boxed{} 中。数据集
Metrics
训练时,设 \(p_i\)、\(q_i\) 分别为第 \(i\) 个位置的 target 与 draft 分布。概率采样的接受率为
\[
a_i
=\sum_v\min\bigl(p_i(v),q_i(v)\bigr)
=1-\tfrac12\lVert p_i-q_i\rVert_1.
\]
估算的平均接受长度 \(\tau\) 由各位置接受率的前缀乘积计算,包含一个 bonus token:
\[
\tau
=1+\sum_{i=0}^{6}\prod_{j=0}^{i}a_j.
\]
生成评测直接统计接受的 draft token 总数(accepted)和验证轮数(rounds)。实测平均接受长度 MAL 按 1 + accepted / rounds 计算,其中 1 表示 bonus token。MOL 为每题平均输出的 token 数。pos-i 表示前 \(i\) 个候选 token 全部被接受的轮次占比。
4.2 MAL vs. Epochs
Baseline 在每个 epoch 包含 2658 个训练 step。pos-\(k\) 表示一次起草中前 \(k\) 个 token 连续被接受的比例。除 GSM8K (5-shot) 外,第 1–10 个 epoch 的结果使用 VLLM_BATCH_INVARIANT=1 评测。MIT 和 MOT 分别为每个成功请求的平均输入和输出 token 数;MT-Bench 合并两轮统计。
GSM8K
Temperature = 0
| Epochs |
T |
Top-p |
Top-k |
Draft 采样 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MIT |
MOT |
| 1 |
0.0 |
1.0 |
-1 |
greedy |
5.8202 |
91.74% |
83.23% |
75.25% |
68.22% |
61.07% |
54.38% |
48.13% |
77.03 |
252.23 |
| 2 |
0.0 |
1.0 |
-1 |
greedy |
6.0613 |
92.82% |
85.42% |
78.22% |
71.66% |
65.36% |
59.28% |
53.37% |
77.03 |
252.23 |
| 3 |
0.0 |
1.0 |
-1 |
greedy |
6.1585 |
93.07% |
86.22% |
79.45% |
73.24% |
67.05% |
61.28% |
55.54% |
77.03 |
252.23 |
| 4 |
0.0 |
1.0 |
-1 |
greedy |
6.2431 |
93.61% |
86.92% |
80.40% |
74.57% |
68.65% |
62.86% |
57.30% |
77.03 |
252.23 |
| 5 |
0.0 |
1.0 |
-1 |
greedy |
6.2975 |
93.88% |
87.60% |
81.10% |
75.31% |
69.52% |
63.90% |
58.45% |
77.03 |
252.23 |
| 6 |
0.0 |
1.0 |
-1 |
greedy |
6.3119 |
93.97% |
87.64% |
81.30% |
75.51% |
69.73% |
64.18% |
58.86% |
77.03 |
252.23 |
| 7 |
0.0 |
1.0 |
-1 |
greedy |
6.3348 |
94.02% |
87.84% |
81.55% |
75.85% |
70.12% |
64.70% |
59.40% |
77.03 |
252.23 |
| 8 |
0.0 |
1.0 |
-1 |
greedy |
6.3463 |
94.13% |
87.92% |
81.65% |
76.02% |
70.30% |
64.91% |
59.69% |
77.03 |
252.23 |
| 9 |
0.0 |
1.0 |
-1 |
greedy |
6.3381 |
94.10% |
87.83% |
81.59% |
75.86% |
70.17% |
64.78% |
59.48% |
77.03 |
252.23 |
| 10 |
0.0 |
1.0 |
-1 |
greedy |
6.3355 |
94.06% |
87.80% |
81.58% |
75.90% |
70.13% |
64.73% |
59.36% |
77.03 |
252.23 |
GSM8K 各 epoch 的接受率(T = 0,Greedy draft)
Temperature = 1
| Epochs |
T |
Top-p |
Top-k |
Draft 采样 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MIT |
MOT |
| 1 |
1.0 |
1.0 |
-1 |
greedy |
5.4361 |
88.87% |
78.41% |
69.37% |
61.76% |
54.74% |
48.15% |
42.32% |
77.03 |
246.99 |
| 2 |
1.0 |
1.0 |
-1 |
greedy |
5.5784 |
89.20% |
79.31% |
71.02% |
64.02% |
57.45% |
51.31% |
45.52% |
77.03 |
250.23 |
| 3 |
1.0 |
1.0 |
-1 |
greedy |
5.6808 |
89.81% |
80.41% |
72.22% |
65.40% |
59.10% |
53.35% |
47.79% |
77.03 |
247.90 |
| 4 |
1.0 |
1.0 |
-1 |
greedy |
5.7340 |
89.95% |
80.87% |
72.83% |
66.33% |
60.13% |
54.30% |
49.00% |
77.03 |
248.87 |
| 5 |
1.0 |
1.0 |
-1 |
greedy |
5.7577 |
90.00% |
81.16% |
73.18% |
66.62% |
60.51% |
54.74% |
49.57% |
77.03 |
249.77 |
| 6 |
1.0 |
1.0 |
-1 |
greedy |
5.8152 |
90.39% |
81.72% |
73.89% |
67.60% |
61.52% |
55.83% |
50.56% |
77.03 |
247.72 |
| 7 |
1.0 |
1.0 |
-1 |
greedy |
5.7961 |
90.30% |
81.46% |
73.78% |
67.23% |
61.20% |
55.46% |
50.19% |
77.03 |
249.79 |
| 8 |
1.0 |
1.0 |
-1 |
greedy |
5.7977 |
90.34% |
81.55% |
73.61% |
67.30% |
61.14% |
55.51% |
50.32% |
77.03 |
248.46 |
| 9 |
1.0 |
1.0 |
-1 |
greedy |
5.8129 |
90.43% |
81.68% |
73.90% |
67.45% |
61.44% |
55.82% |
50.56% |
77.03 |
248.88 |
| 10 |
1.0 |
1.0 |
-1 |
greedy |
5.7984 |
90.30% |
81.53% |
73.57% |
67.30% |
61.29% |
55.54% |
50.32% |
77.03 |
248.92 |
GSM8K 各 epoch 的接受率(T = 1,Greedy draft)
| Epochs |
T |
Top-p |
Top-k |
Draft 采样 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MIT |
MOT |
| 1 |
1.0 |
1.0 |
-1 |
probabilistic |
5.5220 |
90.40% |
80.73% |
71.45% |
63.23% |
55.53% |
48.73% |
42.13% |
77.03 |
250.17 |
| 2 |
1.0 |
1.0 |
-1 |
probabilistic |
5.8165 |
91.76% |
83.52% |
75.21% |
67.83% |
60.82% |
54.38% |
48.12% |
77.03 |
250.28 |
| 3 |
1.0 |
1.0 |
-1 |
probabilistic |
5.9488 |
92.50% |
84.59% |
76.99% |
69.96% |
63.11% |
56.89% |
50.85% |
77.03 |
248.61 |
| 4 |
1.0 |
1.0 |
-1 |
probabilistic |
6.0379 |
92.81% |
85.47% |
77.91% |
71.26% |
64.81% |
58.78% |
52.75% |
77.03 |
247.32 |
| 5 |
1.0 |
1.0 |
-1 |
probabilistic |
6.1044 |
93.34% |
86.24% |
78.96% |
72.38% |
65.86% |
59.83% |
53.83% |
77.03 |
247.99 |
| 6 |
1.0 |
1.0 |
-1 |
probabilistic |
6.1080 |
93.53% |
86.31% |
78.95% |
72.23% |
65.78% |
59.89% |
54.10% |
77.03 |
252.41 |
| 7 |
1.0 |
1.0 |
-1 |
probabilistic |
6.1262 |
93.41% |
86.30% |
79.16% |
72.65% |
66.28% |
60.31% |
54.50% |
77.03 |
251.24 |
| 8 |
1.0 |
1.0 |
-1 |
probabilistic |
6.1381 |
93.54% |
86.50% |
79.34% |
72.86% |
66.41% |
60.47% |
54.71% |
77.03 |
250.11 |
| 9 |
1.0 |
1.0 |
-1 |
probabilistic |
6.1603 |
93.54% |
86.83% |
79.70% |
73.18% |
66.71% |
60.90% |
55.18% |
77.03 |
247.57 |
| 10 |
1.0 |
1.0 |
-1 |
probabilistic |
6.1301 |
93.41% |
86.41% |
79.34% |
72.68% |
66.19% |
60.35% |
54.62% |
77.03 |
252.26 |
GSM8K 各 epoch 的接受率(T = 1,Probabilistic draft)
GSM8K (5-shot)
Temperature = 0
| Epochs |
T |
Top-p |
Top-k |
Draft 采样 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MIT |
MOT |
| 1 |
0.0 |
1.0 |
-1 |
greedy |
4.6719 |
87.15% |
74.92% |
62.53% |
49.50% |
38.85% |
30.38% |
23.86% |
735.03 |
147.46 |
| 2 |
0.0 |
1.0 |
-1 |
greedy |
4.9169 |
87.84% |
76.48% |
65.46% |
53.94% |
43.86% |
35.43% |
28.69% |
735.03 |
147.46 |
| 3 |
0.0 |
1.0 |
-1 |
greedy |
5.0800 |
88.80% |
78.56% |
68.09% |
56.92% |
46.59% |
38.01% |
31.03% |
735.03 |
147.46 |
| 4 |
0.0 |
1.0 |
-1 |
greedy |
5.1509 |
88.98% |
78.93% |
68.62% |
58.11% |
48.47% |
39.58% |
32.41% |
735.03 |
147.46 |
| 5 |
0.0 |
1.0 |
-1 |
greedy |
5.2106 |
90.14% |
79.87% |
69.35% |
58.64% |
49.14% |
40.54% |
33.38% |
735.03 |
147.46 |
| 6 |
0.0 |
1.0 |
-1 |
greedy |
5.2654 |
90.62% |
80.60% |
70.15% |
59.84% |
50.02% |
41.28% |
34.02% |
735.03 |
147.46 |
| 7 |
0.0 |
1.0 |
-1 |
greedy |
5.2342 |
89.88% |
79.65% |
69.47% |
59.37% |
50.02% |
41.18% |
33.86% |
735.03 |
147.46 |
| 8 |
0.0 |
1.0 |
-1 |
greedy |
5.2299 |
90.17% |
79.91% |
69.52% |
59.14% |
49.74% |
40.83% |
33.68% |
735.03 |
147.46 |
| 9 |
0.0 |
1.0 |
-1 |
greedy |
5.2181 |
89.99% |
79.68% |
69.36% |
59.07% |
49.57% |
40.71% |
33.43% |
735.03 |
147.46 |
| 10 |
0.0 |
1.0 |
-1 |
greedy |
5.2111 |
89.95% |
79.57% |
69.20% |
58.98% |
49.45% |
40.62% |
33.34% |
735.03 |
147.46 |
GSM8K (5-shot) 各 epoch 的接受率(T = 0,Greedy draft)
Temperature = 1
| Epochs |
T |
Top-p |
Top-k |
Draft 采样 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MIT |
MOT |
| 1 |
1.0 |
1.0 |
-1 |
greedy |
4.6535 |
86.90% |
74.58% |
62.25% |
49.26% |
38.58% |
30.14% |
23.64% |
735.03 |
144.63 |
| 2 |
1.0 |
1.0 |
-1 |
greedy |
4.8976 |
87.70% |
76.14% |
65.25% |
53.60% |
43.52% |
35.11% |
28.45% |
735.03 |
143.62 |
| 3 |
1.0 |
1.0 |
-1 |
greedy |
5.0336 |
88.28% |
77.72% |
67.33% |
56.20% |
46.10% |
37.43% |
30.30% |
735.03 |
143.61 |
| 4 |
1.0 |
1.0 |
-1 |
greedy |
5.0896 |
88.20% |
77.88% |
67.73% |
57.13% |
47.56% |
38.90% |
31.55% |
735.03 |
144.17 |
| 5 |
1.0 |
1.0 |
-1 |
greedy |
5.1498 |
89.47% |
78.82% |
68.27% |
57.63% |
48.17% |
39.85% |
32.77% |
735.03 |
146.49 |
| 6 |
1.0 |
1.0 |
-1 |
greedy |
5.2187 |
90.24% |
79.83% |
69.42% |
59.07% |
49.22% |
40.57% |
33.53% |
735.03 |
145.05 |
| 7 |
1.0 |
1.0 |
-1 |
greedy |
5.1580 |
89.11% |
78.44% |
68.31% |
57.94% |
48.66% |
40.16% |
33.17% |
735.03 |
144.82 |
| 8 |
1.0 |
1.0 |
-1 |
greedy |
5.1798 |
89.69% |
79.23% |
68.87% |
58.28% |
48.76% |
40.18% |
32.97% |
735.03 |
143.43 |
| 9 |
1.0 |
1.0 |
-1 |
greedy |
5.1965 |
89.42% |
79.16% |
68.88% |
58.77% |
49.30% |
40.77% |
33.35% |
735.03 |
147.86 |
| 10 |
1.0 |
1.0 |
-1 |
greedy |
5.1939 |
89.56% |
79.20% |
68.87% |
58.72% |
49.11% |
40.62% |
33.32% |
735.03 |
146.41 |
GSM8K (5-shot) 各 epoch 的接受率(T = 1,Greedy draft)
| Epochs |
T |
Top-p |
Top-k |
Draft 采样 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MIT |
MOT |
| 1 |
1.0 |
1.0 |
-1 |
probabilistic |
4.5444 |
86.64% |
73.65% |
60.64% |
47.40% |
36.43% |
28.07% |
21.61% |
735.03 |
145.70 |
| 2 |
1.0 |
1.0 |
-1 |
probabilistic |
4.8179 |
87.78% |
75.97% |
64.28% |
52.24% |
41.81% |
33.35% |
26.35% |
735.03 |
143.80 |
| 3 |
1.0 |
1.0 |
-1 |
probabilistic |
4.9861 |
88.57% |
77.72% |
66.86% |
55.36% |
44.90% |
36.27% |
28.93% |
735.03 |
144.87 |
| 4 |
1.0 |
1.0 |
-1 |
probabilistic |
5.0572 |
88.84% |
78.35% |
67.51% |
56.58% |
46.56% |
37.47% |
30.41% |
735.03 |
143.72 |
| 5 |
1.0 |
1.0 |
-1 |
probabilistic |
5.1041 |
89.96% |
79.12% |
68.09% |
57.01% |
47.06% |
38.15% |
31.02% |
735.03 |
143.95 |
| 6 |
1.0 |
1.0 |
-1 |
probabilistic |
5.1866 |
90.43% |
80.01% |
69.39% |
58.73% |
48.49% |
39.59% |
32.03% |
735.03 |
144.54 |
| 7 |
1.0 |
1.0 |
-1 |
probabilistic |
5.1565 |
89.53% |
79.02% |
68.55% |
58.12% |
48.55% |
39.64% |
32.24% |
735.03 |
143.74 |
| 8 |
1.0 |
1.0 |
-1 |
probabilistic |
5.1824 |
90.00% |
79.71% |
69.06% |
58.48% |
48.65% |
40.02% |
32.32% |
735.03 |
143.96 |
| 9 |
1.0 |
1.0 |
-1 |
probabilistic |
5.1509 |
89.78% |
79.22% |
68.64% |
58.06% |
48.22% |
39.33% |
31.85% |
735.03 |
143.41 |
| 10 |
1.0 |
1.0 |
-1 |
probabilistic |
5.1473 |
89.68% |
79.13% |
68.60% |
58.04% |
48.23% |
39.26% |
31.80% |
735.03 |
143.54 |
GSM8K (5-shot) 各 epoch 的接受率(T = 1,Probabilistic draft)
HumanEval
Temperature = 0
| Epochs |
T |
Top-p |
Top-k |
Draft 采样 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MIT |
MOT |
| 1 |
0.0 |
1.0 |
-1 |
greedy |
5.0629 |
87.62% |
75.93% |
65.09% |
56.20% |
47.82% |
40.97% |
32.65% |
167.22 |
355.60 |
| 2 |
0.0 |
1.0 |
-1 |
greedy |
5.4094 |
88.95% |
78.94% |
69.73% |
61.47% |
54.22% |
47.58% |
40.06% |
167.22 |
355.60 |
| 3 |
0.0 |
1.0 |
-1 |
greedy |
5.5943 |
90.44% |
80.01% |
71.70% |
64.25% |
57.28% |
51.15% |
44.60% |
167.22 |
355.60 |
| 4 |
0.0 |
1.0 |
-1 |
greedy |
5.7081 |
91.10% |
81.01% |
73.44% |
66.16% |
59.00% |
53.05% |
47.05% |
167.22 |
355.60 |
| 5 |
0.0 |
1.0 |
-1 |
greedy |
5.7945 |
91.66% |
82.01% |
74.50% |
67.05% |
60.64% |
54.92% |
48.67% |
167.22 |
355.60 |
| 6 |
0.0 |
1.0 |
-1 |
greedy |
5.8293 |
91.99% |
82.20% |
74.65% |
67.64% |
61.25% |
55.66% |
49.54% |
167.22 |
355.60 |
| 7 |
0.0 |
1.0 |
-1 |
greedy |
5.8479 |
91.67% |
82.24% |
74.87% |
68.15% |
61.59% |
56.04% |
50.24% |
167.22 |
355.60 |
| 8 |
0.0 |
1.0 |
-1 |
greedy |
5.8856 |
92.06% |
82.56% |
75.31% |
68.74% |
62.36% |
56.74% |
50.79% |
167.22 |
355.60 |
| 9 |
0.0 |
1.0 |
-1 |
greedy |
5.8965 |
91.99% |
82.82% |
75.44% |
68.66% |
62.71% |
57.02% |
51.00% |
167.22 |
355.60 |
| 10 |
0.0 |
1.0 |
-1 |
greedy |
5.8791 |
91.96% |
82.56% |
75.24% |
68.39% |
62.40% |
56.73% |
50.63% |
167.22 |
355.60 |
HumanEval 各 epoch 的接受率(T = 0,Greedy draft)
Temperature = 1
| Epochs |
T |
Top-p |
Top-k |
Draft 采样 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MIT |
MOT |
| 1 |
1.0 |
1.0 |
-1 |
greedy |
4.9283 |
85.85% |
73.34% |
62.62% |
53.70% |
45.87% |
39.51% |
31.93% |
167.22 |
349.41 |
| 2 |
1.0 |
1.0 |
-1 |
greedy |
5.2380 |
87.21% |
76.16% |
66.58% |
58.58% |
51.83% |
45.29% |
38.15% |
167.22 |
355.56 |
| 3 |
1.0 |
1.0 |
-1 |
greedy |
5.4508 |
89.27% |
77.79% |
69.37% |
61.60% |
55.27% |
48.99% |
42.79% |
167.22 |
347.03 |
| 4 |
1.0 |
1.0 |
-1 |
greedy |
5.5037 |
89.09% |
78.12% |
69.96% |
62.88% |
55.95% |
50.11% |
44.27% |
167.22 |
352.19 |
| 5 |
1.0 |
1.0 |
-1 |
greedy |
5.6665 |
90.21% |
80.06% |
72.36% |
65.06% |
58.92% |
52.83% |
47.21% |
167.22 |
337.01 |
| 6 |
1.0 |
1.0 |
-1 |
greedy |
5.6954 |
90.20% |
80.26% |
72.47% |
65.59% |
59.41% |
53.74% |
47.86% |
167.22 |
348.15 |
| 7 |
1.0 |
1.0 |
-1 |
greedy |
5.6793 |
90.05% |
79.75% |
71.81% |
65.41% |
59.28% |
53.50% |
48.12% |
167.22 |
347.78 |
| 8 |
1.0 |
1.0 |
-1 |
greedy |
5.6867 |
89.99% |
79.82% |
72.18% |
65.39% |
59.43% |
53.67% |
48.19% |
167.22 |
344.46 |
| 9 |
1.0 |
1.0 |
-1 |
greedy |
5.6750 |
90.13% |
79.87% |
71.81% |
65.14% |
59.22% |
53.41% |
47.90% |
167.22 |
349.93 |
| 10 |
1.0 |
1.0 |
-1 |
greedy |
5.6506 |
90.27% |
79.84% |
71.55% |
64.54% |
58.54% |
52.96% |
47.36% |
167.22 |
350.20 |
HumanEval 各 epoch 的接受率(T = 1,Greedy draft)
| Epochs |
T |
Top-p |
Top-k |
Draft 采样 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MIT |
MOT |
| 1 |
1.0 |
1.0 |
-1 |
probabilistic |
4.9830 |
87.32% |
75.41% |
64.51% |
55.15% |
46.27% |
38.78% |
30.86% |
167.22 |
343.87 |
| 2 |
1.0 |
1.0 |
-1 |
probabilistic |
5.3483 |
89.51% |
78.96% |
69.24% |
60.89% |
52.95% |
45.40% |
37.88% |
167.22 |
350.66 |
| 3 |
1.0 |
1.0 |
-1 |
probabilistic |
5.5077 |
90.35% |
79.82% |
70.60% |
62.93% |
55.55% |
49.30% |
42.23% |
167.22 |
351.16 |
| 4 |
1.0 |
1.0 |
-1 |
probabilistic |
5.6256 |
90.63% |
80.87% |
72.63% |
65.04% |
57.46% |
51.17% |
44.77% |
167.22 |
346.99 |
| 5 |
1.0 |
1.0 |
-1 |
probabilistic |
5.7476 |
91.42% |
81.79% |
74.00% |
66.80% |
59.77% |
53.70% |
47.28% |
167.22 |
343.23 |
| 6 |
1.0 |
1.0 |
-1 |
probabilistic |
5.7951 |
91.62% |
82.47% |
74.82% |
67.30% |
60.56% |
54.50% |
48.25% |
167.22 |
344.15 |
| 7 |
1.0 |
1.0 |
-1 |
probabilistic |
5.7900 |
91.55% |
82.44% |
74.20% |
67.05% |
60.67% |
54.67% |
48.42% |
167.22 |
348.27 |
| 8 |
1.0 |
1.0 |
-1 |
probabilistic |
5.7988 |
91.87% |
82.56% |
74.76% |
67.58% |
60.41% |
54.45% |
48.26% |
167.22 |
342.80 |
| 9 |
1.0 |
1.0 |
-1 |
probabilistic |
5.8363 |
91.69% |
82.45% |
74.70% |
67.62% |
61.43% |
55.86% |
49.88% |
167.22 |
346.57 |
| 10 |
1.0 |
1.0 |
-1 |
probabilistic |
5.8081 |
91.62% |
82.25% |
74.24% |
66.91% |
60.97% |
55.42% |
49.40% |
167.22 |
341.73 |
HumanEval 各 epoch 的接受率(T = 1,Probabilistic draft)
MT-Bench
Temperature = 0
| Epochs |
T |
Top-p |
Top-k |
Draft 采样 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MIT |
MOT |
| 1 |
0.0 |
1.0 |
-1 |
greedy |
3.2461 |
71.61% |
49.47% |
34.60% |
25.27% |
18.63% |
14.13% |
10.89% |
330.07 |
496.62 |
| 2 |
0.0 |
1.0 |
-1 |
greedy |
3.4935 |
74.43% |
53.95% |
39.26% |
29.13% |
22.18% |
17.13% |
13.28% |
330.07 |
496.62 |
| 3 |
0.0 |
1.0 |
-1 |
greedy |
3.6453 |
76.33% |
56.63% |
41.88% |
31.58% |
24.22% |
18.87% |
15.03% |
330.07 |
496.62 |
| 4 |
0.0 |
1.0 |
-1 |
greedy |
3.7325 |
77.34% |
57.97% |
43.11% |
32.83% |
25.54% |
20.29% |
16.17% |
330.07 |
496.62 |
| 5 |
0.0 |
1.0 |
-1 |
greedy |
3.8150 |
78.25% |
59.48% |
44.89% |
34.30% |
26.74% |
21.09% |
16.75% |
330.07 |
496.62 |
| 6 |
0.0 |
1.0 |
-1 |
greedy |
3.8570 |
78.59% |
60.30% |
45.51% |
35.11% |
27.28% |
21.69% |
17.23% |
330.07 |
496.62 |
| 7 |
0.0 |
1.0 |
-1 |
greedy |
3.8882 |
78.85% |
60.44% |
46.19% |
35.65% |
27.70% |
22.18% |
17.82% |
330.07 |
496.62 |
| 8 |
0.0 |
1.0 |
-1 |
greedy |
3.9095 |
79.05% |
60.89% |
46.50% |
35.90% |
27.96% |
22.51% |
18.15% |
330.07 |
496.62 |
| 9 |
0.0 |
1.0 |
-1 |
greedy |
3.9248 |
79.42% |
61.10% |
46.78% |
36.21% |
28.26% |
22.57% |
18.15% |
330.07 |
496.62 |
| 10 |
0.0 |
1.0 |
-1 |
greedy |
3.9189 |
79.27% |
61.11% |
46.68% |
36.08% |
28.23% |
22.51% |
18.02% |
330.07 |
496.62 |
MT-Bench 各 epoch 的接受率(T = 0,Greedy draft)
Temperature = 1
| Epochs |
T |
Top-p |
Top-k |
Draft 采样 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MIT |
MOT |
| 1 |
1.0 |
1.0 |
-1 |
greedy |
2.9649 |
67.03% |
44.44% |
29.71% |
20.78% |
14.99% |
11.18% |
8.35% |
349.34 |
522.31 |
| 2 |
1.0 |
1.0 |
-1 |
greedy |
3.1830 |
69.79% |
48.04% |
33.77% |
24.45% |
17.98% |
13.73% |
10.53% |
322.69 |
489.39 |
| 3 |
1.0 |
1.0 |
-1 |
greedy |
3.2858 |
71.00% |
50.09% |
35.50% |
25.98% |
19.42% |
14.94% |
11.65% |
335.27 |
500.48 |
| 4 |
1.0 |
1.0 |
-1 |
greedy |
3.3955 |
71.96% |
51.45% |
37.04% |
27.77% |
21.29% |
16.78% |
13.25% |
325.48 |
505.32 |
| 5 |
1.0 |
1.0 |
-1 |
greedy |
3.3907 |
71.87% |
51.42% |
37.51% |
27.78% |
21.03% |
16.62% |
12.84% |
335.57 |
521.44 |
| 6 |
1.0 |
1.0 |
-1 |
greedy |
3.4018 |
72.07% |
51.86% |
37.39% |
27.83% |
21.37% |
16.59% |
13.06% |
334.04 |
494.40 |
| 7 |
1.0 |
1.0 |
-1 |
greedy |
3.4692 |
73.14% |
53.01% |
38.54% |
29.00% |
22.28% |
17.39% |
13.57% |
339.16 |
508.23 |
| 8 |
1.0 |
1.0 |
-1 |
greedy |
3.4566 |
73.37% |
52.69% |
38.54% |
28.72% |
21.97% |
16.92% |
13.44% |
340.86 |
522.06 |
| 9 |
1.0 |
1.0 |
-1 |
greedy |
3.4934 |
73.42% |
53.38% |
39.15% |
29.40% |
22.51% |
17.60% |
13.88% |
328.59 |
502.01 |
| 10 |
1.0 |
1.0 |
-1 |
greedy |
3.4262 |
72.65% |
52.40% |
37.76% |
28.18% |
21.54% |
16.77% |
13.33% |
328.86 |
492.82 |
MT-Bench 各 epoch 的接受率(T = 1,Greedy draft)
| Epochs |
T |
Top-p |
Top-k |
Draft 采样 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MIT |
MOT |
| 1 |
1.0 |
1.0 |
-1 |
probabilistic |
3.0439 |
69.11% |
46.60% |
31.53% |
21.86% |
15.60% |
11.35% |
8.34% |
318.62 |
479.18 |
| 2 |
1.0 |
1.0 |
-1 |
probabilistic |
3.3082 |
73.21% |
51.83% |
36.40% |
25.95% |
18.85% |
13.97% |
10.61% |
332.81 |
488.57 |
| 3 |
1.0 |
1.0 |
-1 |
probabilistic |
3.4775 |
75.20% |
54.58% |
39.43% |
28.75% |
21.47% |
16.00% |
12.32% |
330.44 |
504.91 |
| 4 |
1.0 |
1.0 |
-1 |
probabilistic |
3.5701 |
76.16% |
56.10% |
41.36% |
30.45% |
22.59% |
17.22% |
13.12% |
325.13 |
494.75 |
| 5 |
1.0 |
1.0 |
-1 |
probabilistic |
3.6120 |
76.74% |
56.88% |
41.76% |
30.80% |
23.47% |
17.86% |
13.69% |
322.40 |
490.70 |
| 6 |
1.0 |
1.0 |
-1 |
probabilistic |
3.6380 |
77.28% |
57.03% |
41.95% |
31.38% |
23.66% |
18.18% |
14.31% |
337.52 |
493.89 |
| 7 |
1.0 |
1.0 |
-1 |
probabilistic |
3.7268 |
77.86% |
58.74% |
43.49% |
32.90% |
25.05% |
19.51% |
15.14% |
341.94 |
523.95 |
| 8 |
1.0 |
1.0 |
-1 |
probabilistic |
3.7357 |
77.78% |
58.78% |
43.70% |
33.27% |
25.31% |
19.43% |
15.30% |
328.54 |
500.29 |
| 9 |
1.0 |
1.0 |
-1 |
probabilistic |
3.7196 |
78.09% |
58.36% |
43.34% |
32.73% |
24.90% |
19.33% |
15.21% |
312.28 |
476.64 |
| 10 |
1.0 |
1.0 |
-1 |
probabilistic |
3.7131 |
77.77% |
59.00% |
43.81% |
32.63% |
24.58% |
18.84% |
14.67% |
326.39 |
488.98 |
MT-Bench 各 epoch 的接受率(T = 1,Probabilistic draft)
MATH-500
Temperature = 0
| Epochs |
T |
Top-p |
Top-k |
Draft 采样 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MIT |
MOT |
| 1 |
0.0 |
1.0 |
-1 |
greedy |
5.7393 |
91.18% |
82.16% |
73.89% |
66.39% |
59.80% |
53.42% |
47.09% |
98.16 |
920.65 |
| 2 |
0.0 |
1.0 |
-1 |
greedy |
6.0163 |
92.44% |
84.51% |
77.34% |
70.79% |
64.68% |
58.82% |
53.05% |
98.16 |
920.65 |
| 3 |
0.0 |
1.0 |
-1 |
greedy |
6.1447 |
93.08% |
85.68% |
78.89% |
72.62% |
66.83% |
61.50% |
55.88% |
98.16 |
920.65 |
| 4 |
0.0 |
1.0 |
-1 |
greedy |
6.2337 |
93.48% |
86.64% |
80.11% |
74.03% |
68.56% |
63.02% |
57.52% |
98.16 |
920.65 |
| 5 |
0.0 |
1.0 |
-1 |
greedy |
6.3050 |
93.88% |
87.48% |
81.00% |
75.06% |
69.69% |
64.30% |
59.08% |
98.16 |
920.65 |
| 6 |
0.0 |
1.0 |
-1 |
greedy |
6.3526 |
94.02% |
87.78% |
81.61% |
75.97% |
70.59% |
65.32% |
59.98% |
98.16 |
920.65 |
| 7 |
0.0 |
1.0 |
-1 |
greedy |
6.3845 |
94.29% |
88.13% |
82.10% |
76.42% |
71.06% |
65.90% |
60.56% |
98.16 |
920.65 |
| 8 |
0.0 |
1.0 |
-1 |
greedy |
6.4006 |
94.41% |
88.36% |
82.26% |
76.59% |
71.23% |
66.15% |
61.05% |
98.16 |
920.65 |
| 9 |
0.0 |
1.0 |
-1 |
greedy |
6.4103 |
94.43% |
88.35% |
82.41% |
76.79% |
71.49% |
66.35% |
61.22% |
98.16 |
920.65 |
| 10 |
0.0 |
1.0 |
-1 |
greedy |
6.4097 |
94.44% |
88.38% |
82.45% |
76.82% |
71.45% |
66.30% |
61.13% |
98.16 |
920.65 |
MATH-500 各 epoch 的接受率(T = 0,Greedy draft)
Temperature = 1
| Epochs |
T |
Top-p |
Top-k |
Draft 采样 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MIT |
MOT |
| 1 |
1.0 |
1.0 |
-1 |
greedy |
4.5941 |
80.27% |
66.32% |
56.16% |
48.37% |
41.82% |
35.95% |
30.50% |
98.16 |
876.64 |
| 2 |
1.0 |
1.0 |
-1 |
greedy |
4.7402 |
80.77% |
67.46% |
58.10% |
50.56% |
44.42% |
38.85% |
33.86% |
98.16 |
916.68 |
| 3 |
1.0 |
1.0 |
-1 |
greedy |
4.8354 |
81.47% |
68.46% |
59.08% |
51.92% |
46.08% |
40.80% |
35.71% |
98.16 |
899.90 |
| 4 |
1.0 |
1.0 |
-1 |
greedy |
4.8619 |
81.68% |
68.69% |
59.49% |
52.39% |
46.51% |
41.15% |
36.29% |
98.16 |
876.71 |
| 5 |
1.0 |
1.0 |
-1 |
greedy |
4.9121 |
81.77% |
69.12% |
60.07% |
53.13% |
47.52% |
42.29% |
37.31% |
98.16 |
909.00 |
| 6 |
1.0 |
1.0 |
-1 |
greedy |
5.0021 |
82.65% |
70.31% |
61.42% |
54.56% |
48.83% |
43.56% |
38.88% |
98.16 |
899.08 |
| 7 |
1.0 |
1.0 |
-1 |
greedy |
4.9612 |
82.21% |
69.81% |
60.88% |
53.94% |
48.03% |
42.95% |
38.29% |
98.16 |
936.80 |
| 8 |
1.0 |
1.0 |
-1 |
greedy |
4.9339 |
82.12% |
69.56% |
60.50% |
53.58% |
47.57% |
42.37% |
37.69% |
98.16 |
894.88 |
| 9 |
1.0 |
1.0 |
-1 |
greedy |
4.9872 |
82.39% |
69.97% |
61.23% |
54.39% |
48.65% |
43.46% |
38.63% |
98.16 |
904.55 |
| 10 |
1.0 |
1.0 |
-1 |
greedy |
4.9842 |
82.28% |
70.02% |
61.25% |
54.36% |
48.55% |
43.35% |
38.59% |
98.16 |
880.68 |
MATH-500 各 epoch 的接受率(T = 1,Greedy draft)
| Epochs |
T |
Top-p |
Top-k |
Draft 采样 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MIT |
MOT |
| 1 |
1.0 |
1.0 |
-1 |
probabilistic |
5.0110 |
86.90% |
74.53% |
63.87% |
54.84% |
47.12% |
40.09% |
33.75% |
98.16 |
890.55 |
| 2 |
1.0 |
1.0 |
-1 |
probabilistic |
5.2793 |
88.30% |
77.14% |
67.52% |
59.21% |
51.70% |
45.14% |
38.90% |
98.16 |
909.76 |
| 3 |
1.0 |
1.0 |
-1 |
probabilistic |
5.4089 |
89.22% |
78.79% |
69.34% |
61.02% |
53.84% |
47.34% |
41.33% |
98.16 |
911.74 |
| 4 |
1.0 |
1.0 |
-1 |
probabilistic |
5.4854 |
89.64% |
79.41% |
70.35% |
62.26% |
55.24% |
48.85% |
42.79% |
98.16 |
868.32 |
| 5 |
1.0 |
1.0 |
-1 |
probabilistic |
5.5808 |
90.17% |
80.42% |
71.56% |
63.75% |
56.81% |
50.66% |
44.71% |
98.16 |
880.81 |
| 6 |
1.0 |
1.0 |
-1 |
probabilistic |
5.6484 |
90.83% |
81.42% |
72.61% |
64.88% |
57.95% |
51.59% |
45.57% |
98.16 |
870.80 |
| 7 |
1.0 |
1.0 |
-1 |
probabilistic |
5.6479 |
90.73% |
81.32% |
72.53% |
64.78% |
57.86% |
51.71% |
45.86% |
98.16 |
878.80 |
| 8 |
1.0 |
1.0 |
-1 |
probabilistic |
5.6743 |
90.85% |
81.63% |
72.90% |
65.18% |
58.24% |
52.26% |
46.37% |
98.16 |
898.26 |
| 9 |
1.0 |
1.0 |
-1 |
probabilistic |
5.7035 |
91.10% |
82.03% |
73.40% |
65.69% |
58.78% |
52.59% |
46.77% |
98.16 |
878.65 |
| 10 |
1.0 |
1.0 |
-1 |
probabilistic |
5.6996 |
91.05% |
82.11% |
73.44% |
65.59% |
58.72% |
52.49% |
46.57% |
98.16 |
899.28 |
MATH-500 各 epoch 的接受率(T = 1,Probabilistic draft)
AIME 2024
Temperature = 0
| Epochs |
T |
Top-p |
Top-k |
Draft 采样 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MIT |
MOT |
| 1 |
0.0 |
1.0 |
-1 |
greedy |
5.6477 |
90.33% |
80.81% |
72.37% |
64.89% |
58.41% |
52.04% |
45.91% |
128.93 |
2963.73 |
| 2 |
0.0 |
1.0 |
-1 |
greedy |
5.8995 |
91.74% |
82.97% |
75.65% |
68.89% |
62.79% |
56.87% |
51.04% |
128.93 |
2963.73 |
| 3 |
0.0 |
1.0 |
-1 |
greedy |
6.0252 |
92.39% |
84.62% |
77.23% |
70.51% |
64.83% |
59.19% |
53.74% |
128.93 |
2963.73 |
| 4 |
0.0 |
1.0 |
-1 |
greedy |
6.0962 |
92.78% |
85.15% |
77.89% |
71.36% |
66.26% |
60.80% |
55.38% |
128.93 |
2963.73 |
| 5 |
0.0 |
1.0 |
-1 |
greedy |
6.1892 |
93.29% |
86.33% |
79.35% |
73.20% |
67.57% |
62.28% |
56.89% |
128.93 |
2963.73 |
| 6 |
0.0 |
1.0 |
-1 |
greedy |
6.2242 |
93.28% |
86.50% |
79.67% |
73.79% |
68.44% |
63.08% |
57.66% |
128.93 |
2963.73 |
| 7 |
0.0 |
1.0 |
-1 |
greedy |
6.2558 |
93.46% |
86.96% |
80.18% |
74.23% |
69.01% |
63.50% |
58.24% |
128.93 |
2963.73 |
| 8 |
0.0 |
1.0 |
-1 |
greedy |
6.2773 |
93.78% |
87.09% |
80.40% |
74.44% |
69.20% |
64.06% |
58.75% |
128.93 |
2963.73 |
| 9 |
0.0 |
1.0 |
-1 |
greedy |
6.2796 |
93.67% |
87.15% |
80.45% |
74.53% |
69.33% |
63.96% |
58.87% |
128.93 |
2963.73 |
| 10 |
0.0 |
1.0 |
-1 |
greedy |
6.2860 |
93.75% |
87.30% |
80.59% |
74.65% |
69.37% |
64.10% |
58.85% |
128.93 |
2963.73 |
AIME 2024 各 epoch 的接受率(T = 0,Greedy draft)
Temperature = 1
| Epochs |
T |
Top-p |
Top-k |
Draft 采样 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MIT |
MOT |
| 1 |
1.0 |
1.0 |
-1 |
greedy |
3.7885 |
73.45% |
55.34% |
43.60% |
35.38% |
28.94% |
23.41% |
18.74% |
128.93 |
2754.93 |
| 2 |
1.0 |
1.0 |
-1 |
greedy |
4.0291 |
74.80% |
58.41% |
47.51% |
39.29% |
32.91% |
27.37% |
22.62% |
128.93 |
3030.87 |
| 3 |
1.0 |
1.0 |
-1 |
greedy |
4.0419 |
74.42% |
58.57% |
47.74% |
39.41% |
33.12% |
27.67% |
23.26% |
128.93 |
2863.17 |
| 4 |
1.0 |
1.0 |
-1 |
greedy |
4.0125 |
74.95% |
58.25% |
47.13% |
38.78% |
32.42% |
27.12% |
22.61% |
128.93 |
2714.17 |
| 5 |
1.0 |
1.0 |
-1 |
greedy |
4.0857 |
75.48% |
59.64% |
48.36% |
40.28% |
33.59% |
28.04% |
23.19% |
128.93 |
2648.90 |
| 6 |
1.0 |
1.0 |
-1 |
greedy |
4.2407 |
76.60% |
61.30% |
50.68% |
42.36% |
36.14% |
30.84% |
26.16% |
128.93 |
2704.77 |
| 7 |
1.0 |
1.0 |
-1 |
greedy |
4.0662 |
74.61% |
58.64% |
47.66% |
39.78% |
33.51% |
28.40% |
24.01% |
128.93 |
3058.17 |
| 8 |
1.0 |
1.0 |
-1 |
greedy |
4.0784 |
75.26% |
59.01% |
48.02% |
39.95% |
33.59% |
28.29% |
23.71% |
128.93 |
2783.63 |
| 9 |
1.0 |
1.0 |
-1 |
greedy |
4.1790 |
75.83% |
60.13% |
49.46% |
41.39% |
35.47% |
30.10% |
25.53% |
128.93 |
2698.27 |
| 10 |
1.0 |
1.0 |
-1 |
greedy |
4.1827 |
76.39% |
60.59% |
49.50% |
41.32% |
35.12% |
29.86% |
25.48% |
128.93 |
2386.87 |
AIME 2024 各 epoch 的接受率(T = 1,Greedy draft)
| Epochs |
T |
Top-p |
Top-k |
Draft 采样 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MIT |
MOT |
| 1 |
1.0 |
1.0 |
-1 |
probabilistic |
4.4083 |
83.06% |
68.00% |
55.31% |
44.87% |
36.47% |
29.40% |
23.72% |
128.93 |
2897.80 |
| 2 |
1.0 |
1.0 |
-1 |
probabilistic |
4.5800 |
84.23% |
70.20% |
57.80% |
47.29% |
39.45% |
32.42% |
26.60% |
128.93 |
2667.17 |
| 3 |
1.0 |
1.0 |
-1 |
probabilistic |
4.7704 |
85.62% |
72.16% |
60.74% |
50.53% |
42.80% |
35.74% |
29.45% |
128.93 |
2817.67 |
| 4 |
1.0 |
1.0 |
-1 |
probabilistic |
4.8102 |
85.95% |
73.01% |
61.42% |
51.47% |
43.25% |
36.06% |
29.85% |
128.93 |
2759.43 |
| 5 |
1.0 |
1.0 |
-1 |
probabilistic |
4.9192 |
86.98% |
74.02% |
62.55% |
53.20% |
45.08% |
38.19% |
31.91% |
128.93 |
2675.77 |
| 6 |
1.0 |
1.0 |
-1 |
probabilistic |
4.9493 |
87.03% |
74.55% |
63.55% |
53.47% |
45.31% |
38.52% |
32.50% |
128.93 |
2747.07 |
| 7 |
1.0 |
1.0 |
-1 |
probabilistic |
5.0377 |
88.28% |
75.93% |
64.51% |
55.16% |
46.93% |
39.59% |
33.38% |
128.93 |
2429.60 |
| 8 |
1.0 |
1.0 |
-1 |
probabilistic |
4.8999 |
87.59% |
74.64% |
62.55% |
52.61% |
44.33% |
37.28% |
30.98% |
128.93 |
2676.00 |
| 9 |
1.0 |
1.0 |
-1 |
probabilistic |
4.9723 |
87.56% |
75.15% |
63.47% |
53.71% |
45.84% |
38.99% |
32.49% |
128.93 |
2688.40 |
| 10 |
1.0 |
1.0 |
-1 |
probabilistic |
5.0160 |
87.11% |
75.18% |
64.63% |
55.10% |
46.79% |
39.56% |
33.24% |
128.93 |
2575.07 |
AIME 2024 各 epoch 的接受率(T = 1,Probabilistic draft)
4.3 MAL vs. Sampling/Verification
T 表示 target temperature,Top-p、Top-k 为 target 截断参数,min-p 固定为 0。Probabilistic draft 使用相同温度,但不做 top-p/top-k 截断;greedy draft 取最大概率 token。T=0 时两者均采用 greedy。使用 huggingface上 deepseek-ai/dspark_qwen3_4b_block7官方权重。
| T |
Top-p |
Top-k |
Draft 采样 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MOL |
| 1.0 |
1.0 |
-1 |
probabilistic |
6.1511 |
93.63% |
86.72% |
79.56% |
73.08% |
66.52% |
60.68% |
54.92% |
248.38 |
| 1.0 |
1.0 |
-1 |
greedy |
5.8528 |
90.82% |
82.53% |
74.72% |
68.03% |
61.80% |
56.39% |
51.00% |
247.51 |
| 0.7 |
0.8 |
20 |
probabilistic |
6.2480 |
93.65% |
87.11% |
80.51% |
74.49% |
68.52% |
63.03% |
57.49% |
247.77 |
| 0.7 |
0.8 |
20 |
greedy |
6.2437 |
93.43% |
86.86% |
80.05% |
74.34% |
68.54% |
63.24% |
57.91% |
251.56 |
| 0.0 |
1.0 |
-1 |
greedy |
6.3085 |
94.02% |
87.69% |
81.16% |
75.44% |
69.54% |
64.18% |
58.82% |
248.44 |
官方 DSpark 权重在不同采样设置下的接受率
在 T=0.7、top-p=0.8、top-k=20 时,两种 draft 采样方式的 MAL 接近。T=1、无截断时,probabilistic 比 greedy 提高约 5.1%,而输出长度接近。Draft 采样方式的收益取决于 target 的采样设置。
4.4 MAL vs. Attention
GQA baseline 采用 online training,以下结果来自 step 2616(约 1 个 epoch)的 checkpoint。本节所有配置均使用 vLLM 的批次不变模式(VLLM_BATCH_INVARIANT=1)评测。MIT 和 MOT 分别为每个成功请求的平均输入和输出 token 数,MT-Bench 按两轮请求合并计算。
GSM8K
Temperature = 0
| Attention |
T |
Top-p |
Top-k |
Draft 采样 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MIT |
MOT |
| GQA |
0.0 |
1.0 |
-1 |
greedy |
5.8081 |
91.64% |
83.02% |
74.86% |
67.86% |
60.83% |
54.35% |
48.25% |
77.03 |
252.23 |
| MLA |
0.0 |
1.0 |
-1 |
greedy |
5.7496 |
91.19% |
82.46% |
74.22% |
66.92% |
59.82% |
53.24% |
47.11% |
77.03 |
252.23 |
| MLA + SWA1024 |
0.0 |
1.0 |
-1 |
greedy |
5.7684 |
91.48% |
82.74% |
74.46% |
67.18% |
60.10% |
53.57% |
47.32% |
77.03 |
252.23 |
| MLA + SWA512 |
0.0 |
1.0 |
-1 |
greedy |
5.7646 |
91.54% |
82.67% |
74.44% |
67.15% |
60.18% |
53.43% |
47.04% |
77.03 |
252.23 |
| MLA + SWA128 |
0.0 |
1.0 |
-1 |
greedy |
5.5412 |
90.45% |
80.70% |
71.57% |
63.52% |
55.95% |
49.17% |
42.76% |
77.03 |
252.23 |
GSM8K 不同 attention 配置的接受率(T = 0,Greedy draft)
Temperature = 1
| Attention |
T |
Top-p |
Top-k |
Draft 采样 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MIT |
MOT |
| GQA |
1.0 |
1.0 |
-1 |
greedy |
5.3723 |
88.22% |
77.51% |
68.30% |
60.81% |
53.78% |
47.32% |
41.31% |
77.03 |
247.23 |
| MLA |
1.0 |
1.0 |
-1 |
greedy |
5.2992 |
87.60% |
76.59% |
67.33% |
59.70% |
52.49% |
46.18% |
40.04% |
77.03 |
249.08 |
| MLA + SWA1024 |
1.0 |
1.0 |
-1 |
greedy |
5.3339 |
87.90% |
77.03% |
67.85% |
60.26% |
53.00% |
46.63% |
40.72% |
77.03 |
250.69 |
| MLA + SWA512 |
1.0 |
1.0 |
-1 |
greedy |
5.3590 |
88.05% |
77.41% |
68.43% |
60.71% |
53.35% |
46.90% |
41.05% |
77.03 |
246.24 |
| MLA + SWA128 |
1.0 |
1.0 |
-1 |
greedy |
5.1569 |
87.06% |
75.45% |
65.44% |
57.26% |
49.84% |
43.36% |
37.27% |
77.03 |
248.10 |
GSM8K 不同 attention 配置的接受率(T = 1,Greedy draft)
| Attention |
T |
Top-p |
Top-k |
Draft 采样 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MIT |
MOT |
| GQA |
1.0 |
1.0 |
-1 |
probabilistic |
5.5257 |
90.46% |
80.70% |
71.52% |
63.38% |
55.70% |
48.75% |
42.06% |
77.03 |
250.60 |
| MLA |
1.0 |
1.0 |
-1 |
probabilistic |
5.5090 |
90.47% |
80.51% |
71.32% |
63.15% |
55.50% |
48.27% |
41.68% |
77.03 |
246.62 |
| MLA + SWA1024 |
1.0 |
1.0 |
-1 |
probabilistic |
5.4968 |
90.14% |
80.28% |
71.20% |
63.15% |
55.30% |
48.10% |
41.51% |
77.03 |
250.66 |
| MLA + SWA512 |
1.0 |
1.0 |
-1 |
probabilistic |
5.5308 |
90.49% |
80.69% |
71.57% |
63.43% |
55.86% |
48.75% |
42.28% |
77.03 |
248.10 |
| MLA + SWA128 |
1.0 |
1.0 |
-1 |
probabilistic |
5.2986 |
89.25% |
78.35% |
68.38% |
59.64% |
51.65% |
44.48% |
38.11% |
77.03 |
249.15 |
GSM8K 不同 attention 配置的接受率(T = 1,Probabilistic draft)
HumanEval
Temperature = 0
| Attention |
T |
Top-p |
Top-k |
Draft 采样 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MIT |
MOT |
| GQA |
0.0 |
1.0 |
-1 |
greedy |
5.0720 |
87.90% |
76.16% |
64.95% |
56.05% |
48.03% |
41.02% |
33.08% |
167.22 |
355.60 |
| MLA |
0.0 |
1.0 |
-1 |
greedy |
4.9656 |
87.37% |
74.59% |
64.43% |
54.43% |
45.71% |
38.62% |
31.42% |
167.22 |
355.60 |
| MLA + SWA1024 |
0.0 |
1.0 |
-1 |
greedy |
4.9943 |
87.79% |
74.93% |
64.33% |
54.71% |
46.67% |
39.23% |
31.77% |
167.22 |
355.60 |
| MLA + SWA512 |
0.0 |
1.0 |
-1 |
greedy |
4.9392 |
87.64% |
75.10% |
63.80% |
53.97% |
45.32% |
38.11% |
29.98% |
167.22 |
355.60 |
| MLA + SWA128 |
0.0 |
1.0 |
-1 |
greedy |
4.1271 |
83.51% |
65.32% |
51.65% |
39.48% |
30.89% |
23.85% |
18.01% |
167.22 |
355.60 |
HumanEval 不同 attention 配置的接受率(T = 0,Greedy draft)
Temperature = 1
| Attention |
T |
Top-p |
Top-k |
Draft 采样 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MIT |
MOT |
| GQA |
1.0 |
1.0 |
-1 |
greedy |
4.9558 |
86.34% |
74.06% |
63.01% |
54.29% |
46.54% |
39.46% |
31.88% |
167.22 |
349.23 |
| MLA |
1.0 |
1.0 |
-1 |
greedy |
4.8544 |
85.66% |
72.67% |
61.80% |
52.98% |
44.48% |
37.25% |
30.60% |
167.22 |
340.86 |
| MLA + SWA1024 |
1.0 |
1.0 |
-1 |
greedy |
4.8475 |
85.62% |
72.91% |
61.85% |
52.29% |
44.24% |
37.37% |
30.46% |
167.22 |
359.45 |
| MLA + SWA512 |
1.0 |
1.0 |
-1 |
greedy |
4.8413 |
86.00% |
73.07% |
61.57% |
52.49% |
44.18% |
37.11% |
29.71% |
167.22 |
346.05 |
| MLA + SWA128 |
1.0 |
1.0 |
-1 |
greedy |
4.0716 |
82.79% |
64.75% |
50.39% |
38.64% |
29.82% |
23.21% |
17.56% |
167.22 |
350.45 |
HumanEval 不同 attention 配置的接受率(T = 1,Greedy draft)
| Attention |
T |
Top-p |
Top-k |
Draft 采样 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MIT |
MOT |
| GQA |
1.0 |
1.0 |
-1 |
probabilistic |
4.9465 |
87.86% |
75.15% |
63.85% |
54.14% |
45.50% |
38.08% |
30.08% |
167.22 |
342.76 |
| MLA |
1.0 |
1.0 |
-1 |
probabilistic |
4.8005 |
86.86% |
73.49% |
61.94% |
52.06% |
42.73% |
35.18% |
27.80% |
167.22 |
354.16 |
| MLA + SWA1024 |
1.0 |
1.0 |
-1 |
probabilistic |
4.8782 |
87.33% |
74.88% |
63.29% |
53.16% |
44.23% |
36.51% |
28.41% |
167.22 |
345.13 |
| MLA + SWA512 |
1.0 |
1.0 |
-1 |
probabilistic |
4.7607 |
86.51% |
73.18% |
61.38% |
51.23% |
42.30% |
34.68% |
26.78% |
167.22 |
356.76 |
| MLA + SWA128 |
1.0 |
1.0 |
-1 |
probabilistic |
4.0219 |
83.20% |
64.56% |
49.83% |
37.62% |
28.69% |
22.05% |
16.25% |
167.22 |
348.04 |
HumanEval 不同 attention 配置的接受率(T = 1,Probabilistic draft)
MT-Bench
Temperature = 0
| Attention |
T |
Top-p |
Top-k |
Draft 采样 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MIT |
MOT |
| GQA |
0.0 |
1.0 |
-1 |
greedy |
3.2192 |
71.35% |
49.12% |
34.32% |
24.75% |
18.20% |
13.73% |
10.45% |
330.07 |
496.62 |
| MLA |
0.0 |
1.0 |
-1 |
greedy |
3.1872 |
70.78% |
48.64% |
33.71% |
24.14% |
17.95% |
13.37% |
10.13% |
330.07 |
496.62 |
| MLA + SWA1024 |
0.0 |
1.0 |
-1 |
greedy |
3.1888 |
70.82% |
48.57% |
33.93% |
24.52% |
17.79% |
13.21% |
10.02% |
330.07 |
496.62 |
| MLA + SWA512 |
0.0 |
1.0 |
-1 |
greedy |
3.1498 |
70.41% |
48.22% |
33.23% |
23.68% |
17.24% |
12.72% |
9.47% |
330.07 |
496.62 |
| MLA + SWA128 |
0.0 |
1.0 |
-1 |
greedy |
3.0069 |
69.72% |
46.41% |
30.78% |
20.98% |
14.71% |
10.51% |
7.58% |
330.07 |
496.62 |
MT-Bench 不同 attention 配置的接受率(T = 0,Greedy draft)
Temperature = 1
| Attention |
T |
Top-p |
Top-k |
Draft 采样 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MIT |
MOT |
| GQA |
1.0 |
1.0 |
-1 |
greedy |
2.9251 |
66.66% |
43.10% |
29.14% |
20.34% |
14.56% |
10.69% |
8.03% |
332.02 |
506.57 |
| MLA |
1.0 |
1.0 |
-1 |
greedy |
2.9163 |
66.09% |
43.51% |
29.12% |
20.21% |
14.42% |
10.56% |
7.73% |
335.16 |
512.76 |
| MLA + SWA1024 |
1.0 |
1.0 |
-1 |
greedy |
2.9232 |
66.25% |
43.38% |
29.03% |
20.39% |
14.55% |
10.75% |
7.97% |
327.84 |
497.79 |
| MLA + SWA512 |
1.0 |
1.0 |
-1 |
greedy |
2.8322 |
64.97% |
42.14% |
27.53% |
18.65% |
13.25% |
9.58% |
7.11% |
338.49 |
504.70 |
| MLA + SWA128 |
1.0 |
1.0 |
-1 |
greedy |
2.7499 |
65.02% |
40.73% |
26.09% |
17.30% |
11.77% |
8.21% |
5.87% |
335.26 |
506.69 |
MT-Bench 不同 attention 配置的接受率(T = 1,Greedy draft)
| Attention |
T |
Top-p |
Top-k |
Draft 采样 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MIT |
MOT |
| GQA |
1.0 |
1.0 |
-1 |
probabilistic |
2.9906 |
68.60% |
45.33% |
30.75% |
20.96% |
14.82% |
10.69% |
7.92% |
334.19 |
504.07 |
| MLA |
1.0 |
1.0 |
-1 |
probabilistic |
3.0085 |
68.63% |
46.01% |
30.91% |
21.38% |
15.12% |
10.89% |
7.91% |
336.27 |
506.57 |
| MLA + SWA1024 |
1.0 |
1.0 |
-1 |
probabilistic |
3.0033 |
68.63% |
45.85% |
31.01% |
21.27% |
14.94% |
10.80% |
7.83% |
334.19 |
510.62 |
| MLA + SWA512 |
1.0 |
1.0 |
-1 |
probabilistic |
2.9466 |
67.90% |
44.68% |
29.74% |
20.27% |
14.32% |
10.25% |
7.49% |
323.75 |
488.98 |
| MLA + SWA128 |
1.0 |
1.0 |
-1 |
probabilistic |
2.8430 |
67.37% |
43.54% |
27.99% |
18.61% |
12.40% |
8.51% |
5.87% |
331.40 |
507.61 |
MT-Bench 不同 attention 配置的接受率(T = 1,Probabilistic draft)
MATH-500
Temperature = 0
| Attention |
T |
Top-p |
Top-k |
Draft 采样 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MIT |
MOT |
| GQA |
0.0 |
1.0 |
-1 |
greedy |
5.7178 |
91.13% |
81.87% |
73.61% |
66.18% |
59.30% |
52.99% |
46.70% |
98.16 |
920.65 |
| MLA |
0.0 |
1.0 |
-1 |
greedy |
5.6722 |
90.67% |
81.30% |
73.00% |
65.50% |
58.73% |
52.23% |
45.79% |
98.16 |
920.65 |
| MLA + SWA1024 |
0.0 |
1.0 |
-1 |
greedy |
5.6608 |
90.69% |
81.46% |
72.89% |
65.29% |
58.45% |
51.85% |
45.46% |
98.16 |
920.65 |
| MLA + SWA512 |
0.0 |
1.0 |
-1 |
greedy |
5.6203 |
90.65% |
81.12% |
72.43% |
64.66% |
57.69% |
51.03% |
44.45% |
98.16 |
920.65 |
| MLA + SWA128 |
0.0 |
1.0 |
-1 |
greedy |
5.3370 |
89.85% |
79.15% |
68.93% |
60.02% |
52.21% |
45.06% |
38.47% |
98.16 |
920.65 |
MATH-500 不同 attention 配置的接受率(T = 0,Greedy draft)
Temperature = 1
| Attention |
T |
Top-p |
Top-k |
Draft 采样 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MIT |
MOT |
| GQA |
1.0 |
1.0 |
-1 |
greedy |
4.5708 |
80.12% |
66.08% |
55.88% |
47.88% |
41.34% |
35.53% |
30.24% |
98.16 |
906.51 |
| MLA |
1.0 |
1.0 |
-1 |
greedy |
4.5401 |
79.77% |
65.69% |
55.52% |
47.53% |
40.87% |
34.94% |
29.68% |
98.16 |
898.91 |
| MLA + SWA1024 |
1.0 |
1.0 |
-1 |
greedy |
4.4842 |
79.41% |
65.05% |
54.40% |
46.46% |
39.87% |
34.23% |
29.00% |
98.16 |
881.63 |
| MLA + SWA512 |
1.0 |
1.0 |
-1 |
greedy |
4.5478 |
80.11% |
65.81% |
55.39% |
47.62% |
40.99% |
35.13% |
29.72% |
98.16 |
869.69 |
| MLA + SWA128 |
1.0 |
1.0 |
-1 |
greedy |
4.3920 |
79.95% |
64.95% |
53.72% |
44.83% |
37.80% |
31.66% |
26.28% |
98.16 |
874.39 |
MATH-500 不同 attention 配置的接受率(T = 1,Greedy draft)
| Attention |
T |
Top-p |
Top-k |
Draft 采样 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MIT |
MOT |
| GQA |
1.0 |
1.0 |
-1 |
probabilistic |
4.9716 |
86.65% |
73.97% |
63.22% |
54.09% |
46.43% |
39.54% |
33.26% |
98.16 |
904.44 |
| MLA |
1.0 |
1.0 |
-1 |
probabilistic |
4.9205 |
86.16% |
73.29% |
62.45% |
53.24% |
45.59% |
38.80% |
32.52% |
98.16 |
875.30 |
| MLA + SWA1024 |
1.0 |
1.0 |
-1 |
probabilistic |
4.9178 |
86.25% |
73.30% |
62.26% |
53.13% |
45.51% |
38.78% |
32.55% |
98.16 |
899.65 |
| MLA + SWA512 |
1.0 |
1.0 |
-1 |
probabilistic |
4.9083 |
86.23% |
73.34% |
62.31% |
53.08% |
45.27% |
38.39% |
32.19% |
98.16 |
897.81 |
| MLA + SWA128 |
1.0 |
1.0 |
-1 |
probabilistic |
4.7245 |
85.92% |
72.04% |
60.11% |
49.99% |
41.71% |
34.40% |
28.28% |
98.16 |
891.02 |
MATH-500 不同 attention 配置的接受率(T = 1,Probabilistic draft)
AIME 2024
Temperature = 0
| Attention |
T |
Top-p |
Top-k |
Draft 采样 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MIT |
MOT |
| GQA |
0.0 |
1.0 |
-1 |
greedy |
5.6210 |
90.21% |
80.40% |
71.78% |
64.24% |
57.91% |
51.67% |
45.90% |
128.93 |
2963.73 |
| MLA |
0.0 |
1.0 |
-1 |
greedy |
5.5596 |
89.95% |
79.72% |
70.85% |
63.44% |
56.90% |
50.69% |
44.43% |
128.93 |
2963.73 |
| MLA + SWA1024 |
0.0 |
1.0 |
-1 |
greedy |
5.5170 |
89.45% |
79.37% |
70.44% |
62.75% |
56.08% |
49.80% |
43.79% |
128.93 |
2963.73 |
| MLA + SWA512 |
0.0 |
1.0 |
-1 |
greedy |
5.4038 |
88.97% |
78.32% |
69.02% |
60.97% |
54.31% |
47.69% |
41.11% |
128.93 |
2963.73 |
| MLA + SWA128 |
0.0 |
1.0 |
-1 |
greedy |
5.0380 |
88.26% |
76.14% |
64.58% |
55.19% |
47.03% |
39.65% |
32.93% |
128.93 |
2963.73 |
AIME 2024 不同 attention 配置的接受率(T = 0,Greedy draft)
Temperature = 1
| Attention |
T |
Top-p |
Top-k |
Draft 采样 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MIT |
MOT |
| GQA |
1.0 |
1.0 |
-1 |
greedy |
3.7891 |
73.19% |
55.54% |
43.98% |
35.36% |
28.76% |
23.31% |
18.76% |
128.93 |
2769.07 |
| MLA |
1.0 |
1.0 |
-1 |
greedy |
3.7612 |
73.12% |
55.50% |
43.32% |
34.78% |
28.10% |
22.98% |
18.31% |
128.93 |
2527.50 |
| MLA + SWA1024 |
1.0 |
1.0 |
-1 |
greedy |
3.7312 |
72.79% |
55.08% |
42.95% |
34.43% |
27.74% |
22.31% |
17.80% |
128.93 |
2694.77 |
| MLA + SWA512 |
1.0 |
1.0 |
-1 |
greedy |
3.6856 |
72.68% |
54.42% |
42.08% |
33.41% |
27.12% |
21.70% |
17.15% |
128.93 |
2851.00 |
| MLA + SWA128 |
1.0 |
1.0 |
-1 |
greedy |
3.6094 |
72.55% |
54.29% |
41.66% |
32.29% |
25.01% |
19.77% |
15.37% |
128.93 |
3087.17 |
AIME 2024 不同 attention 配置的接受率(T = 1,Greedy draft)
| Attention |
T |
Top-p |
Top-k |
Draft 采样 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MIT |
MOT |
| GQA |
1.0 |
1.0 |
-1 |
probabilistic |
4.3014 |
82.12% |
66.39% |
53.39% |
42.98% |
34.67% |
28.19% |
22.39% |
128.93 |
2783.83 |
| MLA |
1.0 |
1.0 |
-1 |
probabilistic |
4.2519 |
81.61% |
65.82% |
52.94% |
42.42% |
33.94% |
27.08% |
21.40% |
128.93 |
2398.60 |
| MLA + SWA1024 |
1.0 |
1.0 |
-1 |
probabilistic |
4.2352 |
82.17% |
66.02% |
52.44% |
42.05% |
33.68% |
26.60% |
20.57% |
128.93 |
2878.23 |
| MLA + SWA512 |
1.0 |
1.0 |
-1 |
probabilistic |
4.1791 |
81.40% |
64.82% |
51.31% |
41.09% |
32.78% |
26.11% |
20.40% |
128.93 |
2671.40 |
| MLA + SWA128 |
1.0 |
1.0 |
-1 |
probabilistic |
4.0042 |
81.18% |
63.48% |
49.32% |
37.97% |
29.31% |
22.39% |
16.77% |
128.93 |
2671.37 |
AIME 2024 不同 attention 配置的接受率(T = 1,Probabilistic draft)
4.5 MAL vs. Markov-Engram
Markov-Engram(结构见 1.4 节)采用 online training,以下结果来自 step 7974(约 3 个 epoch)的 checkpoint,评测均为 greedy 验证。表中 Baseline 行为 4.2 节第 3 个 epoch 的结果,两者训练量相同。除 GSM8K 为 5-shot 外,各基准的设置与 4.2 节一致。
GSM8K (5-shot)
Temperature = 0
| 模型 |
T |
Top-p |
Top-k |
Draft 采样 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MIT |
MOT |
| Baseline |
0.0 |
1.0 |
-1 |
greedy |
5.0800 |
88.80% |
78.56% |
68.09% |
56.92% |
46.59% |
38.01% |
31.03% |
735.03 |
147.46 |
| Markov-Engram |
0.0 |
1.0 |
-1 |
greedy |
5.0563 |
88.51% |
77.55% |
67.08% |
56.16% |
46.65% |
38.32% |
31.36% |
735.03 |
147.46 |
GSM8K (5-shot) 上 Baseline 与 Markov-Engram 的接受率(均 3 epoch,T = 0,Greedy draft)
Temperature = 1
| 模型 |
T |
Top-p |
Top-k |
Draft 采样 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MIT |
MOT |
| Baseline |
1.0 |
1.0 |
-1 |
greedy |
5.0336 |
88.28% |
77.72% |
67.33% |
56.20% |
46.10% |
37.43% |
30.30% |
735.03 |
143.61 |
| Markov-Engram |
1.0 |
1.0 |
-1 |
greedy |
5.0395 |
88.27% |
77.23% |
66.67% |
56.05% |
46.31% |
38.05% |
31.38% |
735.03 |
145.27 |
GSM8K (5-shot) 上 Baseline 与 Markov-Engram 的接受率(均 3 epoch,T = 1,Greedy draft)
| 模型 |
T |
Top-p |
Top-k |
Draft 采样 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MIT |
MOT |
| Baseline |
1.0 |
1.0 |
-1 |
probabilistic |
4.9861 |
88.57% |
77.72% |
66.86% |
55.36% |
44.90% |
36.27% |
28.93% |
735.03 |
144.87 |
| Markov-Engram |
1.0 |
1.0 |
-1 |
probabilistic |
4.9887 |
88.22% |
76.95% |
66.20% |
55.09% |
45.21% |
37.16% |
30.04% |
735.03 |
144.65 |
GSM8K (5-shot) 上 Baseline 与 Markov-Engram 的接受率(均 3 epoch,T = 1,Probabilistic draft)
HumanEval
Temperature = 0
| 模型 |
T |
Top-p |
Top-k |
Draft 采样 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MIT |
MOT |
| Baseline |
0.0 |
1.0 |
-1 |
greedy |
5.5943 |
90.44% |
80.01% |
71.70% |
64.25% |
57.28% |
51.15% |
44.60% |
167.22 |
355.60 |
| Markov-Engram |
0.0 |
1.0 |
-1 |
greedy |
5.6395 |
90.32% |
80.04% |
72.35% |
65.06% |
58.03% |
52.21% |
45.93% |
167.22 |
355.60 |
HumanEval 上 Baseline 与 Markov-Engram 的接受率(均 3 epoch,T = 0,Greedy draft)
Temperature = 1
| 模型 |
T |
Top-p |
Top-k |
Draft 采样 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MIT |
MOT |
| Baseline |
1.0 |
1.0 |
-1 |
greedy |
5.4508 |
89.27% |
77.79% |
69.37% |
61.60% |
55.27% |
48.99% |
42.79% |
167.22 |
347.03 |
| Markov-Engram |
1.0 |
1.0 |
-1 |
greedy |
5.5098 |
88.70% |
78.12% |
70.19% |
62.94% |
56.46% |
50.24% |
44.33% |
167.22 |
345.15 |
HumanEval 上 Baseline 与 Markov-Engram 的接受率(均 3 epoch,T = 1,Greedy draft)
| 模型 |
T |
Top-p |
Top-k |
Draft 采样 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MIT |
MOT |
| Baseline |
1.0 |
1.0 |
-1 |
probabilistic |
5.5077 |
90.35% |
79.82% |
70.60% |
62.93% |
55.55% |
49.30% |
42.23% |
167.22 |
351.16 |
| Markov-Engram |
1.0 |
1.0 |
-1 |
probabilistic |
5.5533 |
90.69% |
80.29% |
71.42% |
63.79% |
56.03% |
49.73% |
43.38% |
167.22 |
347.61 |
HumanEval 上 Baseline 与 Markov-Engram 的接受率(均 3 epoch,T = 1,Probabilistic draft)
MT-Bench
Temperature = 0
| 模型 |
T |
Top-p |
Top-k |
Draft 采样 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MIT |
MOT |
| Baseline |
0.0 |
1.0 |
-1 |
greedy |
3.6453 |
76.33% |
56.63% |
41.88% |
31.58% |
24.22% |
18.87% |
15.03% |
330.07 |
496.62 |
| Markov-Engram |
0.0 |
1.0 |
-1 |
greedy |
3.6997 |
76.54% |
56.99% |
42.85% |
32.78% |
25.27% |
19.87% |
15.68% |
330.08 |
496.63 |
MT-Bench 上 Baseline 与 Markov-Engram 的接受率(均 3 epoch,T = 0,Greedy draft)
Temperature = 1
| 模型 |
T |
Top-p |
Top-k |
Draft 采样 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MIT |
MOT |
| Baseline |
1.0 |
1.0 |
-1 |
greedy |
3.2858 |
71.00% |
50.09% |
35.50% |
25.98% |
19.42% |
14.94% |
11.65% |
335.27 |
500.48 |
| Markov-Engram |
1.0 |
1.0 |
-1 |
greedy |
3.2837 |
70.87% |
49.75% |
35.58% |
26.10% |
19.36% |
14.95% |
11.75% |
329.58 |
493.81 |
MT-Bench 上 Baseline 与 Markov-Engram 的接受率(均 3 epoch,T = 1,Greedy draft)
| 模型 |
T |
Top-p |
Top-k |
Draft 采样 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MIT |
MOT |
| Baseline |
1.0 |
1.0 |
-1 |
probabilistic |
3.4775 |
75.20% |
54.58% |
39.43% |
28.75% |
21.47% |
16.00% |
12.32% |
330.44 |
504.91 |
| Markov-Engram |
1.0 |
1.0 |
-1 |
probabilistic |
3.4927 |
74.71% |
54.49% |
39.68% |
29.09% |
21.89% |
16.57% |
12.85% |
336.36 |
513.70 |
MT-Bench 上 Baseline 与 Markov-Engram 的接受率(均 3 epoch,T = 1,Probabilistic draft)
MATH-500
Temperature = 0
| 模型 |
T |
Top-p |
Top-k |
Draft 采样 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MIT |
MOT |
| Baseline |
0.0 |
1.0 |
-1 |
greedy |
6.1447 |
93.08% |
85.68% |
78.89% |
72.62% |
66.83% |
61.50% |
55.88% |
98.16 |
920.65 |
| Markov-Engram |
0.0 |
1.0 |
-1 |
greedy |
6.1814 |
93.00% |
85.83% |
79.24% |
73.23% |
67.64% |
62.26% |
56.93% |
98.16 |
920.65 |
MATH-500 上 Baseline 与 Markov-Engram 的接受率(均 3 epoch,T = 0,Greedy draft)
Temperature = 1
| 模型 |
T |
Top-p |
Top-k |
Draft 采样 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MIT |
MOT |
| Baseline |
1.0 |
1.0 |
-1 |
greedy |
4.8354 |
81.47% |
68.46% |
59.08% |
51.92% |
46.08% |
40.80% |
35.71% |
98.16 |
899.90 |
| Markov-Engram |
1.0 |
1.0 |
-1 |
greedy |
4.8451 |
81.48% |
68.64% |
59.40% |
52.15% |
46.14% |
40.74% |
35.95% |
98.16 |
869.76 |
MATH-500 上 Baseline 与 Markov-Engram 的接受率(均 3 epoch,T = 1,Greedy draft)
| 模型 |
T |
Top-p |
Top-k |
Draft 采样 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MIT |
MOT |
| Baseline |
1.0 |
1.0 |
-1 |
probabilistic |
5.4089 |
89.22% |
78.79% |
69.34% |
61.02% |
53.84% |
47.34% |
41.33% |
98.16 |
911.74 |
| Markov-Engram |
1.0 |
1.0 |
-1 |
probabilistic |
5.4818 |
89.42% |
79.01% |
69.99% |
62.12% |
55.23% |
49.05% |
43.36% |
98.16 |
875.20 |
MATH-500 上 Baseline 与 Markov-Engram 的接受率(均 3 epoch,T = 1,Probabilistic draft)
AIME 2024
Temperature = 0
| 模型 |
T |
Top-p |
Top-k |
Draft 采样 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MIT |
MOT |
| Baseline |
0.0 |
1.0 |
-1 |
greedy |
6.0252 |
92.39% |
84.62% |
77.23% |
70.51% |
64.83% |
59.19% |
53.74% |
128.93 |
2963.73 |
| Markov-Engram |
0.0 |
1.0 |
-1 |
greedy |
6.0360 |
92.08% |
84.02% |
77.17% |
70.82% |
65.20% |
59.86% |
54.44% |
128.93 |
2963.73 |
AIME 2024 上 Baseline 与 Markov-Engram 的接受率(均 3 epoch,T = 0,Greedy draft)
Temperature = 1
| 模型 |
T |
Top-p |
Top-k |
Draft 采样 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MIT |
MOT |
| Baseline |
1.0 |
1.0 |
-1 |
greedy |
4.0419 |
74.42% |
58.57% |
47.74% |
39.41% |
33.12% |
27.67% |
23.26% |
128.93 |
2863.17 |
| Markov-Engram |
1.0 |
1.0 |
-1 |
greedy |
4.1258 |
75.63% |
59.75% |
48.73% |
40.69% |
34.52% |
29.07% |
24.21% |
128.93 |
2840.43 |
AIME 2024 上 Baseline 与 Markov-Engram 的接受率(均 3 epoch,T = 1,Greedy draft)
| 模型 |
T |
Top-p |
Top-k |
Draft 采样 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MIT |
MOT |
| Baseline |
1.0 |
1.0 |
-1 |
probabilistic |
4.7704 |
85.62% |
72.16% |
60.74% |
50.53% |
42.80% |
35.74% |
29.45% |
128.93 |
2817.67 |
| Markov-Engram |
1.0 |
1.0 |
-1 |
probabilistic |
4.8643 |
85.83% |
72.49% |
61.65% |
52.51% |
44.71% |
37.58% |
31.65% |
128.93 |
2593.07 |
AIME 2024 上 Baseline 与 Markov-Engram 的接受率(均 3 epoch,T = 1,Probabilistic draft)
相同训练量(3 epoch)下,Markov-Engram 在 15 组对比中的 13 组 MAL 高于 baseline,且收益随输出变长而扩大:GSM8K(5-shot)基本持平(-0.5%–+0.1%),HumanEval 高 0.8%–1.1%,MT-Bench 高 0.4%–1.5%(T = 1 greedy 持平),MATH-500 高 0.2%–1.3%,AIME 高 0.2%–2.1%。
各基准上 T = 0 的 MAL 均最高,随 temperature 升高而下降,输出长度也随之变短。T = 1 时 probabilistic draft 一致高于 greedy draft,两者差距随任务变长而扩大:GSM8K(5-shot,MOT 约 145)上 greedy 反而略高 1.0%,HumanEval(MOT 约 350)高 0.8%,MT-Bench(MOT 约 500)高 6.4%,MATH-500(MOT 约 870)高 13.1%,AIME(MOT 约 2600–2900)高 17.9%,且差距主要来自 pos-1(如 AIME 85.8% vs. 75.6%)。长输出任务上 target 分布更平坦,greedy draft 的概率质量更集中,拒绝采样损失更大;n-gram 记忆对短输出的 GSM8K 帮助有限(T = 0 时 MAL 5.06,低于 HumanEval 的 5.64),与 4.2 节 GSM8K 5-shot 接受率整体偏低的现象一致。
4.6 Markov MLA
Baseline 和 Backbone MLA + Markov MLA 均采用 online training,学习率为 3e-4,训练 1 个 epoch。评测时,客户端并发数与服务端最大请求数均为 32。
| T |
Top-p |
Top-k |
Draft 采样 |
模型 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MOL |
| 0.7 |
0.8 |
20 |
probabilistic |
Baseline |
5.5296 |
90.66% |
80.98% |
71.91% |
63.88% |
55.85% |
48.38% |
41.32% |
245.48 |
| 0.7 |
0.8 |
20 |
probabilistic |
Markov MLA |
5.5191 |
90.11% |
80.34% |
71.45% |
63.58% |
55.78% |
48.67% |
41.99% |
246.44 |
| 0.7 |
0.8 |
20 |
greedy |
Baseline |
5.5286 |
90.15% |
80.46% |
71.62% |
63.67% |
55.85% |
48.84% |
42.27% |
247.83 |
| 0.7 |
0.8 |
20 |
greedy |
Markov MLA |
5.5041 |
89.79% |
79.81% |
70.92% |
63.17% |
55.67% |
48.76% |
42.30% |
246.93 |
| 1.0 |
1.0 |
-1 |
probabilistic |
Baseline |
5.3181 |
89.75% |
79.12% |
69.09% |
60.25% |
51.88% |
44.34% |
37.36% |
249.02 |
| 1.0 |
1.0 |
-1 |
probabilistic |
Markov MLA |
5.3552 |
89.37% |
78.82% |
69.21% |
60.69% |
52.76% |
45.70% |
38.98% |
247.19 |
| 1.0 |
1.0 |
-1 |
greedy |
Baseline |
5.2065 |
87.52% |
76.22% |
66.42% |
58.17% |
50.62% |
44.03% |
37.68% |
249.29 |
| 1.0 |
1.0 |
-1 |
greedy |
Markov MLA |
5.2404 |
87.78% |
76.47% |
66.93% |
58.78% |
51.21% |
44.56% |
38.32% |
246.08 |
| 0.0 |
1.0 |
-1 |
greedy |
Baseline |
5.6057 |
90.94% |
81.60% |
72.69% |
64.87% |
57.19% |
50.05% |
43.24% |
252.05 |
| 0.0 |
1.0 |
-1 |
greedy |
Markov MLA |
5.6015 |
90.49% |
81.18% |
72.38% |
64.56% |
57.24% |
50.39% |
43.91% |
251.15 |
Baseline 与 Markov MLA 的接受率对比
4.7 Markov GQA
Markov GQA 沿用 baseline 的 5 层 GQA backbone,在 Markov head 的 W₁ 与 W₂ 之间加入 GQA(32 个 Q heads、8 个 KV heads)。该 GQA 的位置对应 Fig. 1 中 Markov head 的 MLA。Baseline 与 Markov GQA 均采用 online training,训练约 10 个 epoch。
| T |
Top-p |
Top-k |
Draft 采样 |
模型 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MOL |
| 0.7 |
0.8 |
20 |
probabilistic |
Baseline |
6.2462 |
93.69% |
87.20% |
80.60% |
74.52% |
68.51% |
62.78% |
57.31% |
249.19 |
| 0.7 |
0.8 |
20 |
probabilistic |
Markov GQA |
6.1649 |
92.88% |
86.01% |
78.97% |
73.16% |
67.31% |
61.68% |
56.47% |
247.49 |
| 0.7 |
0.8 |
20 |
greedy |
Baseline |
6.2296 |
93.44% |
86.80% |
80.13% |
74.21% |
68.27% |
62.70% |
57.41% |
252.57 |
| 0.7 |
0.8 |
20 |
greedy |
Markov GQA |
6.1676 |
92.79% |
85.90% |
79.08% |
73.12% |
67.29% |
61.87% |
56.72% |
251.82 |
| 1.0 |
1.0 |
-1 |
probabilistic |
Baseline |
6.1923 |
93.70% |
86.86% |
80.04% |
73.65% |
67.37% |
61.75% |
55.87% |
249.34 |
| 1.0 |
1.0 |
-1 |
probabilistic |
Markov GQA |
6.1198 |
93.08% |
85.97% |
78.63% |
72.41% |
66.26% |
60.61% |
55.02% |
247.33 |
| 1.0 |
1.0 |
-1 |
greedy |
Baseline |
5.8211 |
90.49% |
81.81% |
74.07% |
67.62% |
61.44% |
56.05% |
50.63% |
249.36 |
| 1.0 |
1.0 |
-1 |
greedy |
Markov GQA |
5.8080 |
90.33% |
81.65% |
73.83% |
67.22% |
61.24% |
55.82% |
50.71% |
248.13 |
| 0.0 |
1.0 |
-1 |
greedy |
Baseline |
6.3319 |
94.05% |
87.84% |
81.67% |
75.89% |
69.96% |
64.65% |
59.13% |
248.59 |
| 0.0 |
1.0 |
-1 |
greedy |
Markov GQA |
6.2771 |
93.50% |
87.18% |
80.53% |
74.88% |
69.12% |
63.81% |
58.68% |
251.46 |
Baseline 与 Markov GQA 在 GSM8K 上的接受率
| T |
Top-p |
Top-k |
Draft 采样 |
模型 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
| 0.7 |
0.8 |
20 |
probabilistic |
Baseline |
5.9714 |
92.38% |
83.54% |
75.99% |
69.73% |
64.13% |
58.61% |
52.76% |
| 0.7 |
0.8 |
20 |
probabilistic |
Markov GQA |
5.7729 |
90.91% |
81.45% |
73.74% |
66.66% |
60.28% |
54.98% |
49.25% |
| 0.7 |
0.8 |
20 |
greedy |
Baseline |
5.8489 |
91.77% |
82.23% |
74.83% |
67.70% |
61.66% |
56.27% |
50.44% |
| 0.7 |
0.8 |
20 |
greedy |
Markov GQA |
5.8488 |
91.69% |
82.17% |
74.78% |
67.74% |
61.56% |
56.41% |
50.53% |
| 1.0 |
1.0 |
-1 |
probabilistic |
Baseline |
5.8079 |
91.71% |
82.40% |
74.41% |
67.07% |
60.75% |
55.17% |
49.29% |
| 1.0 |
1.0 |
-1 |
probabilistic |
Markov GQA |
5.7864 |
91.15% |
82.20% |
74.21% |
67.43% |
60.40% |
54.58% |
48.68% |
| 1.0 |
1.0 |
-1 |
greedy |
Baseline |
5.6532 |
89.78% |
79.80% |
72.02% |
64.69% |
58.60% |
53.01% |
47.41% |
| 1.0 |
1.0 |
-1 |
greedy |
Markov GQA |
5.6432 |
89.89% |
79.29% |
71.84% |
64.56% |
58.37% |
52.92% |
47.46% |
| 0.0 |
1.0 |
-1 |
greedy |
Baseline |
5.9855 |
92.37% |
83.40% |
76.22% |
69.69% |
64.31% |
59.31% |
53.25% |
| 0.0 |
1.0 |
-1 |
greedy |
Markov GQA |
6.0151 |
92.12% |
83.67% |
77.03% |
70.07% |
64.44% |
59.68% |
54.51% |
Baseline 与 Markov GQA 在 HumanEval 上的接受率
| T |
Top-p |
Top-k |
Draft 采样 |
模型 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
| 0.7 |
0.8 |
20 |
probabilistic |
Baseline |
3.8245 |
78.76% |
59.46% |
45.31% |
34.40% |
26.65% |
21.14% |
16.73% |
| 0.7 |
0.8 |
20 |
probabilistic |
Markov GQA |
3.7522 |
77.29% |
58.14% |
43.86% |
33.50% |
25.75% |
20.32% |
16.36% |
| 0.7 |
0.8 |
20 |
greedy |
Baseline |
3.7655 |
77.80% |
58.53% |
43.83% |
33.69% |
26.06% |
20.38% |
16.26% |
| 0.7 |
0.8 |
20 |
greedy |
Markov GQA |
3.8650 |
77.41% |
58.94% |
45.50% |
35.34% |
27.87% |
22.79% |
18.65% |
| 1.0 |
1.0 |
-1 |
probabilistic |
Baseline |
3.7381 |
78.23% |
59.17% |
44.30% |
33.14% |
24.80% |
19.14% |
15.03% |
| 1.0 |
1.0 |
-1 |
probabilistic |
Markov GQA |
3.6771 |
76.88% |
57.71% |
42.89% |
32.12% |
24.47% |
18.96% |
14.69% |
| 1.0 |
1.0 |
-1 |
greedy |
Baseline |
3.4888 |
73.58% |
53.50% |
39.30% |
29.25% |
22.29% |
17.20% |
13.77% |
| 1.0 |
1.0 |
-1 |
greedy |
Markov GQA |
3.4255 |
72.12% |
52.19% |
37.93% |
28.30% |
21.80% |
16.94% |
13.26% |
| 0.0 |
1.0 |
-1 |
greedy |
Baseline |
4.0498 |
79.90% |
62.64% |
48.69% |
38.38% |
30.34% |
24.59% |
20.43% |
| 0.0 |
1.0 |
-1 |
greedy |
Markov GQA |
4.0402 |
79.30% |
61.57% |
48.06% |
38.13% |
30.73% |
25.27% |
20.95% |
Baseline 与 Markov GQA 在 MT-Bench 上的接受率
4.8 Baseline vs. DrawSpec
DrawSpec 将五层 backbone 分为四层预计算和一层条件化,最后一层输入为 anchor + 6 states。此处使用 late-conditioning 分支的 12-state 权重,与 baseline 均训练约 1 epoch,target temperature 为 0.7。
| 模型 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
MOL |
| Baseline |
5.5271 |
90.67% |
81.04% |
71.74% |
63.77% |
55.84% |
48.34% |
41.32% |
247.98 |
| DrawSpec |
4.7163 |
85.80% |
70.82% |
59.19% |
49.87% |
41.73% |
35.07% |
29.14% |
248.58 |
Baseline 与 DrawSpec 的接受率对比(T = 0.7)
两组输出长度接近,DrawSpec 的 MAL 下降约 14.7%。
5 历史评测
GSM8K 评测脚本对照(官方权重)
使用官方 draft 权重 deepseek-ai/dspark_qwen3_4b_block7,在 target temperature 为 1、top-p 为 1、top-k 为 -1、min-p 为 0 且 draft 采用概率采样时,DeepSpec 和本文脚本在 GSM8K 0-shot 上的 MAL 分别为 6.1305 和 6.1511,平均每题输出长度分别为 305.63 和 248.38 个 token。DeepSpec 的提示要求逐步推理并用 \boxed{} 标出答案。
早期 online / offline 评测记录
5.1 Online training 与官方权重
在 vLLM 服务上评测 GSM8K test 全集 1,319 题。自训练 baseline 训练至 step 2616(约 1 epoch)。Prompt 使用 Question: {question}\nAnswer: 格式。Target 使用 non-thinking,采样参数为 temperature=0.7、top-p=0.8、top-k=20、min-p=0;Draft 均采用 greedy,每轮提出 7 个 draft tokens。
| 权重 |
峰值学习率 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
| 自训练 Online |
\(3\times10^{-4}\) |
4.3013 |
85.29% |
70.73% |
56.23% |
42.57% |
32.30% |
24.66% |
18.34% |
| 官方权重 |
— |
5.1804 |
89.00% |
78.72% |
68.65% |
58.42% |
49.22% |
40.80% |
33.21% |
GSM8K 上 online 训练权重与官方权重的接受率
5.2 Offline training(5-shot)
| 权重 |
峰值学习率 |
MAL |
pos-1 |
pos-2 |
pos-3 |
pos-4 |
pos-5 |
pos-6 |
pos-7 |
| 自训练 Offline |
\(6\times10^{-4}\) |
4.5908 |
86.33% |
73.03% |
60.17% |
48.10% |
38.23% |
29.82% |
23.40% |
Offline 训练权重在 GSM8K (5-shot) 上的接受率